什么是 Transformer?
Transformer 是一种神经网络架构,从根本上改变了人工智能的研究方式。它最早于 2017 年在开创性论文 "Attention is All You Need" 中被首次提出,此后成为深度学习模型的首选架构,驱动着 OpenAI 的 GPT、Meta 的 Llama 和 Google 的 Gemini 等文本生成模型。除文本外,Transformer 还应用于 音频生成、 图像识别、 蛋白质结构预测,甚至 游戏博弈,展现出跨众多领域的通用性。
本质上,文本生成类 Transformer 模型基于下一个词预测的原理工作:给定用户输入的文本提示,最有可能跟随其后的下一个词是什么?Transformer 的核心创新与威力在于使用了自注意力机制,使其能够处理整个序列,并比以往架构更有效地捕捉长程依赖关系。
GPT-2 系列模型是文本生成 Transformer 的典型代表。本交互式讲解工具由 GPT-2 (small)模型驱动,该模型拥有 1.24 亿参数。虽然它不是最新、最强大的 Transformer 模型,但它与当前最先进模型共享许多相同的架构组件与原理,是理解其基础知识的理想起点。
Transformer 架构
每个文本生成 Transformer 都由以下三个关键组件构成:
- 嵌入(Embedding):文本输入被划分为更小的单元——token(可以是词或子词)。这些 token 被转换为称为嵌入的数值向量,用以捕捉词语的语义含义。
- Transformer 块是处理和转换输入数据的模型基本构建单元。每个块包含:
- Attention Mechanism, the core component of the Transformer block. It allows tokens to communicate with other tokens, capturing contextual information and relationships between words.
- MLP (Multilayer Perceptron) Layer, a feed-forward network that operates on each token independently. While the goal of the attention layer is to route information between tokens, the goal of the MLP is to refine each token's representation.
- 输出概率:最后的线性层与 softmax 层将处理后的嵌入转换为概率分布,使模型能够预测序列中的下一个 token。
嵌入(Embedding)
假设你想用 Transformer 模型生成文本,输入如下提示:“Data visualization empowers users to”。该输入需要转换为模型能够理解和处理的格式,这正是嵌入的作用:它将文本转换为模型可处理的数值表示。要将提示转换为嵌入,需要:1)对输入分词;2)获取 token 嵌入;3)添加位置信息;最后 4)将 token 嵌入与位置编码相加,得到最终嵌入。下面看看每一步是如何完成的。
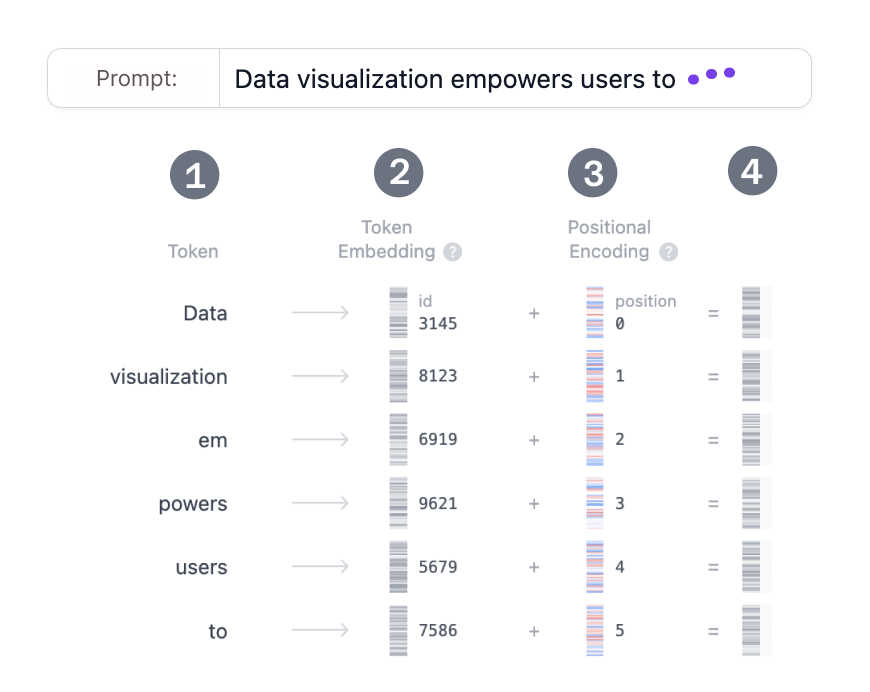
第 1 步:分词(Tokenization)
分词是将输入文本拆解为更小、更易处理的单元(token)的过程。token 可以是一个词或一个子词。例如 "Data" 和 "visualization" 各自对应唯一的 token,而 "empowers" 则被拆分为两个 token。完整的 token 词表在训练模型之前就已确定:GPT-2 的词表包含 50,257 个唯一 token。将输入文本拆分为具有不同 ID 的 token 后,就可以从嵌入矩阵中获取它们的向量表示。
第 2 步:Token 嵌入
GPT-2(small)将词表中的每个 token 表示为 768 维向量(向量维度取决于模型)。这些嵌入向量存储在一个形状为 (50,257, 768) 的矩阵中,包含约 3900 万个参数!这个庞大的矩阵使模型能够为每个 token 赋予语义含义。
第 3 步:位置编码
嵌入层还会编码每个 token 在输入提示中的位置信息。不同模型使用不同的位置编码方法。GPT-2 从零开始训练自己的位置编码矩阵,并将其直接整合到训练过程中。
第 4 步:最终嵌入
最后,将 token 嵌入与位置编码相加,得到最终嵌入表示。这种组合表示同时捕捉了 token 的语义含义及其在输入序列中的位置。
Transformer 块
Transformer 的处理核心在于 Transformer 块,它由多头自注意力和多层感知机(MLP)层组成。大多数模型由多个这样的块依次堆叠而成。token 表示从第一个块到最后一个块逐层演化,使模型逐步构建对每个 token 的深入理解。这种分层方式形成输入的高阶表示。我们考察的 GPT-2(small)模型由 12 个这样的块组成。
多头自注意力
自注意力机制使模型能够关注输入序列中的相关部分,从而捕捉数据中复杂的关系与依赖。下面逐步看看自注意力是如何计算的。
第 1 步:查询(Q)、键(K)、值(V)矩阵
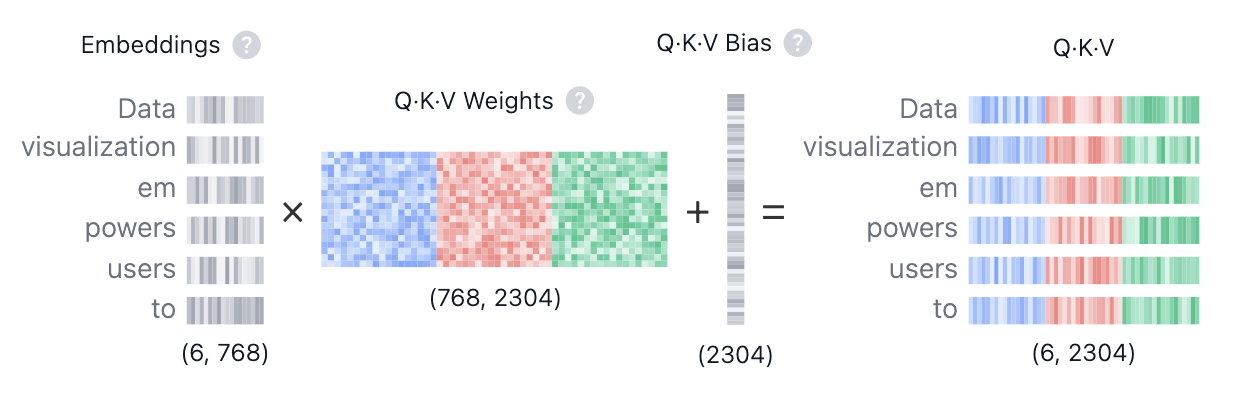
每个 token 的嵌入向量被变换为三个向量: Query (Q), Key (K), and Value (V)。这些向量通过将输入嵌入矩阵与相应的可学习权重矩阵相乘得到: Q, K, and V。下面用一个网络搜索的类比来帮助建立对这些矩阵的直觉理解:
- 查询 Q(Query)相当于你在搜索引擎框中输入的搜索词,即你想要"找到更多信息"的那个 token。
- 键 K(Key)相当于搜索结果窗口中每个网页的标题,代表查询可能关注的候选 token。
- 值 V(Value)相当于网页中展示的实际内容。一旦将搜索词(Q)与相关结果(K)匹配上,我们就想获取最相关页面的内容(V)。
利用这些 QKV 值,模型可以计算注意力分数,决定生成预测时每个 token 应获得多少关注。
第 2 步:多头拆分
Query, key, and
Value
向量被拆分为多个头——GPT-2(small)拆分为 12 个头。每个头独立处理嵌入的一个片段,捕捉不同的句法与语义关系。这种设计有利于并行学习多样化的语言特征,增强模型的表示能力。
第 3 步:掩码自注意力
在每个头中执行掩码自注意力计算。该机制让模型在生成序列时聚焦输入的相关部分,同时阻止其访问未来的 token。
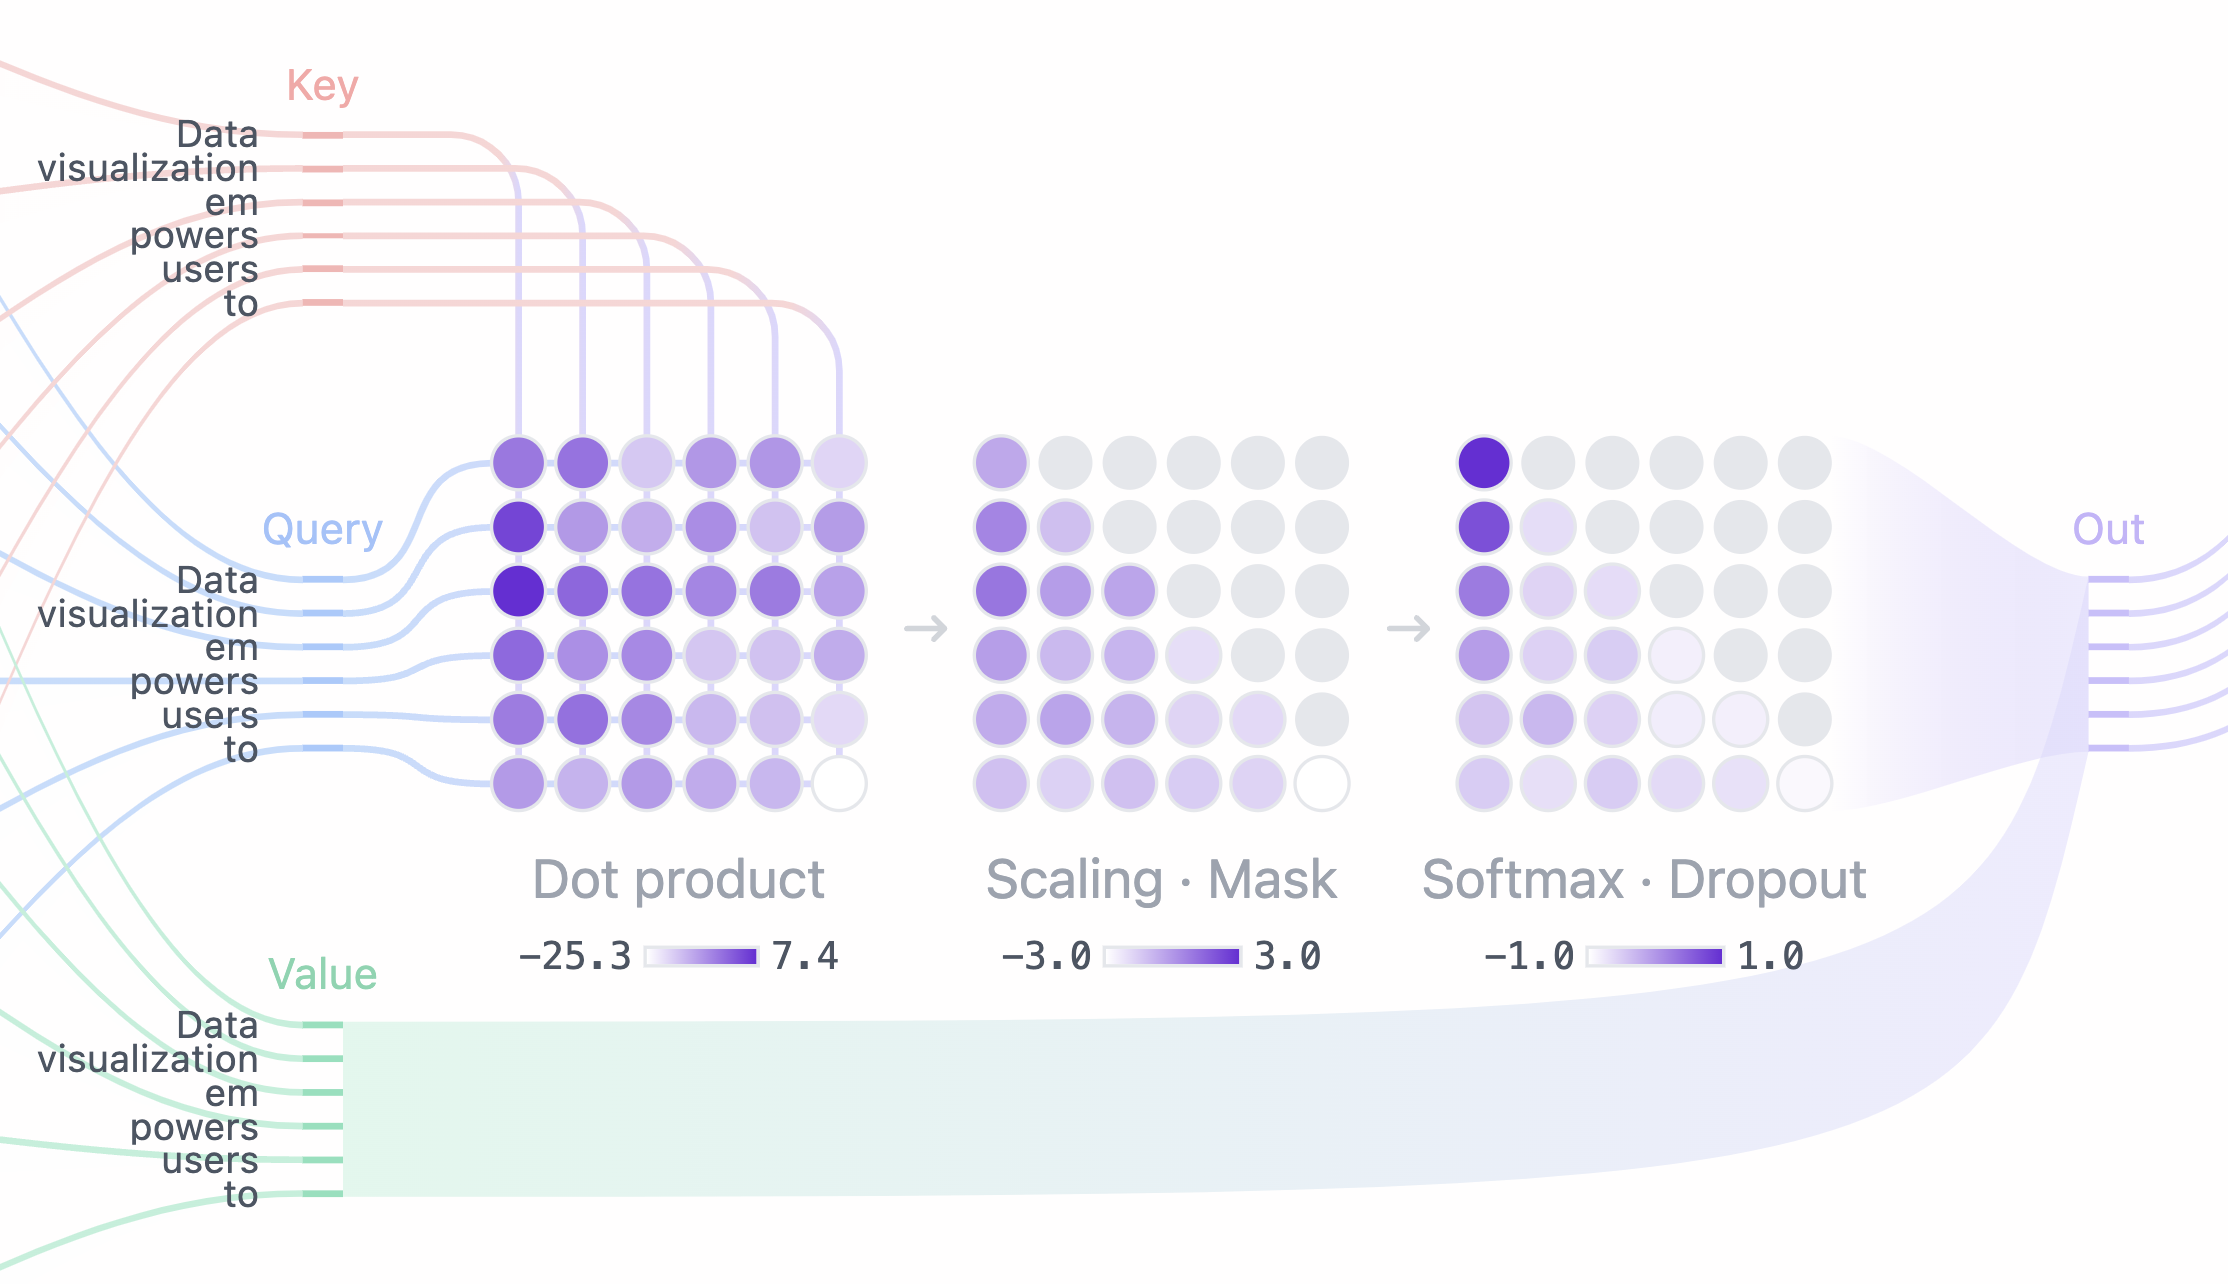
- 注意力分数: Query 与 Key 矩阵的点积,决定每个查询与每个键的对齐程度,生成一个反映所有输入 token 之间关系的方阵。
- 掩码:在注意力矩阵的上三角区域应用掩码,将这些值设为负无穷,阻止模型访问未来的 token。模型需要学会在不“偷看”未来的情况下预测下一个 token。
- Softmax:掩码之后,softmax 运算对每个注意力分数取指数,将其转换为概率。矩阵每行之和为 1,表示其左侧每个 token 与当前 token 的相关程度。
第 4 步:输出与拼接
模型将掩码自注意力分数与值 V 矩阵相乘,得到自注意力机制的最终输出。GPT-2 有 12 个自注意力头,各自捕捉 token 之间的不同关系。这些头的输出被拼接起来,再经过一次线性投影。
MLP:多层感知机
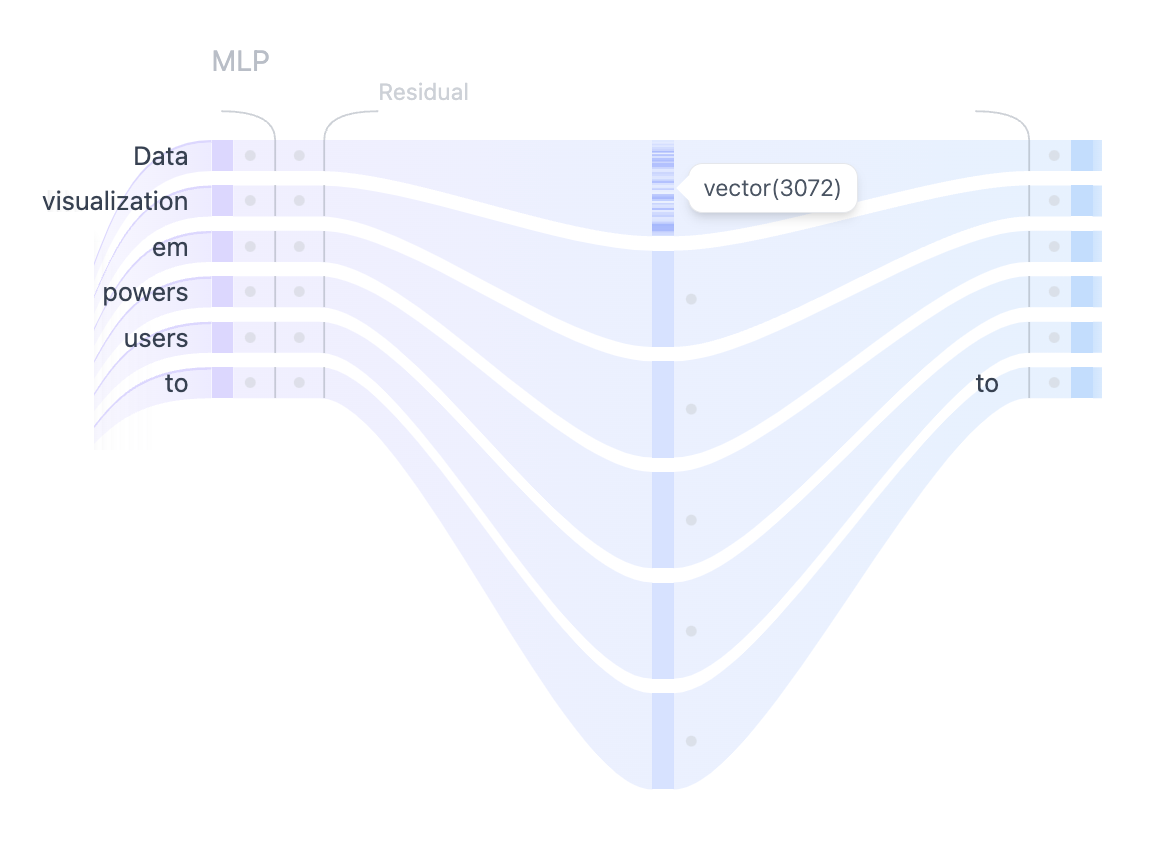
在多头自注意力捕捉输入 token 之间的多样关系后,拼接的输出被送入多层感知机(MLP)层,以增强模型的表示能力。MLP 块由两个线性变换和中间的 GELU 激活函数组成。第一个线性变换将输入维度从 768 扩大四倍至 3072;第二个线性变换将维度降回原来的 768,确保后续层接收到维度一致的输入。与自注意力机制不同,MLP 独立处理每个 token,只是将其从一种表示映射到另一种表示。
输出概率
输入经过所有 Transformer 块处理后,输出被送入最后的线性层,为 token 预测做准备。该层将最终表示投影到 50,257 维空间,词表中每个 token 在此都有一个对应的值,称为 logit。任何 token 都可能是下一个词,因此该过程让我们可以按成为下一个词的可能性对这些 token 排序。然后应用 softmax 函数,将 logit 转换为总和为 1 的概率分布,从而可以按可能性采样下一个 token。
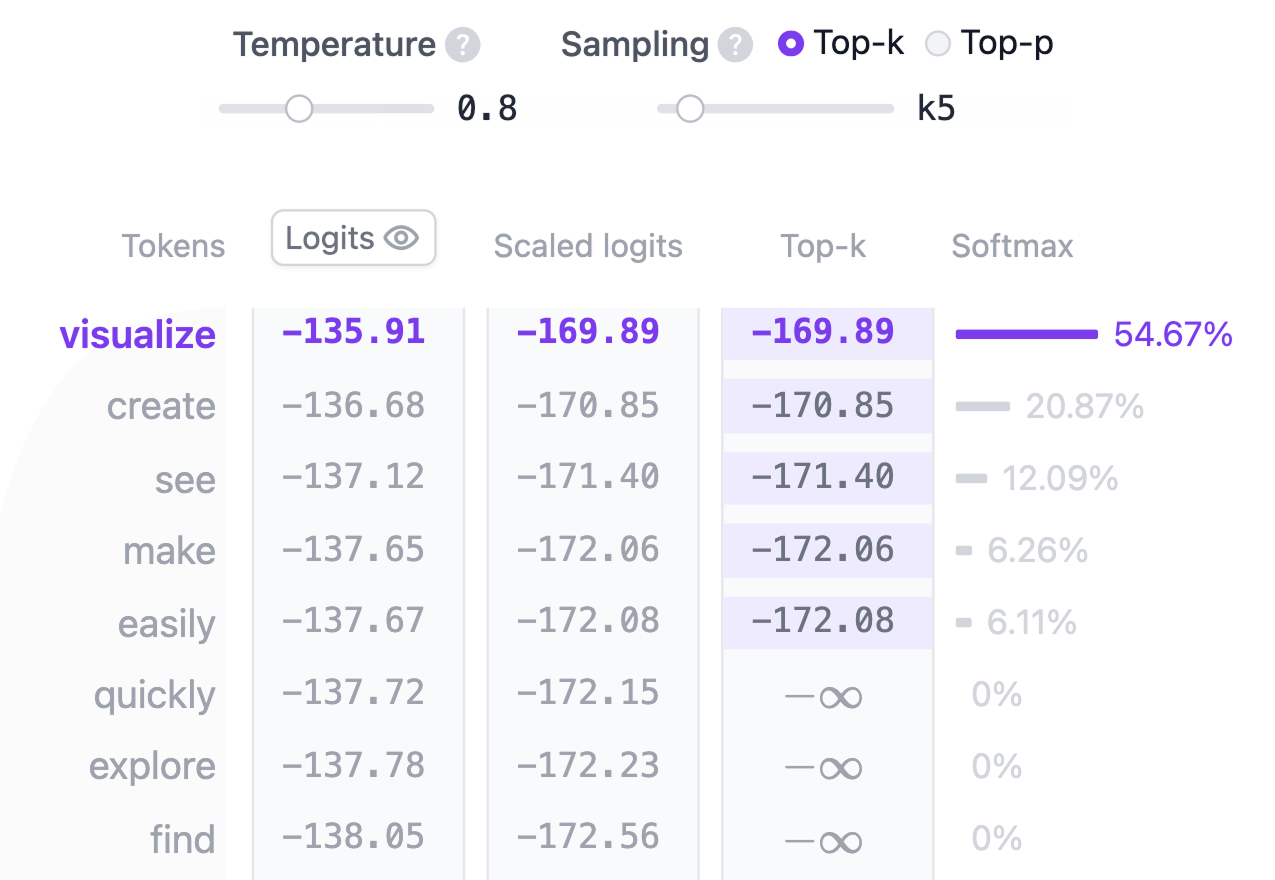
最后一步是从该分布中采样以生成下一个 token。temperature(温度)超参数在此过程中起关键作用。从数学上讲,这个操作非常简单:将模型输出的 logit 直接除以温度:
temperature = 1:logit 除以 1 不影响 softmax 输出。temperature < 1:较低温度使概率分布更尖锐,模型更自信、更具确定性,输出更可预测。temperature > 1:较高温度使概率分布更平缓,生成的文本更具随机性——即有人所说的模型“创造力”。
此外,还可以使用 top-k 和 top-p 参数进一步优化采样过程:
top-k 采样:将候选 token 限制为概率最高的前 k 个,过滤掉可能性较低的选项。top-p 采样:考虑累积概率超过阈值 p 的最小 token 集合,确保只有最可能的 token 参与采样,同时保留多样性。
通过调节 temperature、top-k 和 top-p,你可以在确定性与多样性输出之间取得平衡,使模型行为契合你的具体需求。
高级架构特性
还有几个提升 Transformer 模型性能的高级架构特性。它们对模型整体性能很重要,但对理解架构核心概念并非必需。层归一化(Layer Normalization)、Dropout 和残差连接(Residual Connections)是 Transformer 模型中的关键组件,尤其在训练阶段:层归一化稳定训练并帮助模型更快收敛;Dropout 通过随机失活神经元防止过拟合;残差连接让梯度直接流经网络,有助于防止梯度消失问题。
层归一化(Layer Normalization)
层归一化有助于稳定训练过程并改善收敛。它通过跨特征对输入进行归一化,确保激活值的均值与方差保持一致。这种归一化有助于缓解内部协变量偏移问题,使模型更有效地学习,并降低对初始权重的敏感性。每个 Transformer 块中应用两次层归一化:一次在自注意力机制之前,一次在 MLP 层之前。
Dropout
Dropout 是一种正则化技术,通过在训练期间随机将一部分模型权重置零来防止神经网络过拟合。这促使模型学习更鲁棒的特征,减少对特定神经元的依赖,帮助网络更好地泛化到未见数据。模型推理时 dropout 会被停用——这本质上相当于使用了训练得到的子网络集成,从而获得更好的模型性能。
残差连接(Residual Connections)
残差连接于 2015 年在 ResNet 模型中首次提出。这一架构创新使训练非常深的神经网络成为可能,彻底改变了深度学习。本质上,残差连接是跨过一个或多个层的捷径,将层的输入加到其输出上。这有助于缓解梯度消失问题,使堆叠多个 Transformer 块的深层网络更易于训练。在 GPT-2 中,每个 Transformer 块内使用两次残差连接:一次在 MLP 之前,一次在其后,确保梯度更顺畅地流动,让较早的层在反向传播中获得充分更新。
交互功能
本工具是交互式的,你可以借此探索 Transformer 的内部工作原理。以下是一些可以上手体验的交互功能:
- 输入你自己的文本序列,查看模型如何处理并预测下一个词。探索注意力权重与中间计算过程,观察最终输出概率如何计算。
- 使用温度滑块控制模型预测的随机性。探索如何通过改变温度值让模型输出更确定或更有“创造力”。
- 选择 top-k 与 top-p 采样方法调整推理时的采样行为。尝试不同的取值,观察概率分布的变化及其对模型预测的影响。
- 与注意力图交互,查看模型如何关注输入序列中的不同 token。将鼠标悬停在 token 上可高亮其注意力权重,探索模型如何捕捉上下文与词间关系。
视频教程
原视频教程托管于 YouTube,受网络环境限制已移除。可结合上方交互式演示与文字讲解进行学习。
本工具是如何实现的?
本工具在浏览器中直接运行一个实时的 GPT-2(small)模型。该模型源自 Andrej Karpathy 的 nanoGPT project 的 GPT PyTorch 实现,并已转换为 ONNX Runtime ,以便在浏览器中无缝执行。界面使用 JavaScript 构建,采用 Svelte 作为前端框架,并使用 D3.js 创建动态可视化。数值会随用户输入实时更新。
谁开发了这个工具?
Transformer Explainer 由以下开发者创建: Aeree Cho, Grace C. Kim, Alexander Karpekov, Alec Helbling, Jay Wang, Seongmin Lee, Benjamin Hoover, and Polo Chau (均来自佐治亚理工学院)。