原文:Nanopore direct RNA sequencing and the epitranscriptome: Advances in mapping native RNA landscapes. PubMed | PMC 全文(含 PDF)
在生命科学的中心法则中,RNA早已不再是DNA与蛋白质之间简单的“信使”。从编码RNA到非编码RNA,从转录调控到转录后加工,再到表观转录组层面的化学修饰与RNA编辑,各类RNA分子共同构成了一个高度动态、精细调控的网络,保障着基因表达在时空上的精确性与功能多样性。其中,以N6-甲基腺苷(m6A)为代表的RNA修饰,作为可逆、动态的表观转录组标记,深度参与了转录本稳定性、剪接、核输出、翻译效率以及RNA降解等过程。
过去三十年,RNA测序技术经历了从短读长RNA-seq(以Illumina为代表),到长读长cDNA测序(以PacBio和Oxford Nanopore Technologies, ONT为代表),再到近十年兴起的纳米孔直接RNA测序(direct RNA sequencing, DRS)的演进。然而,无论是短读长还是基于cDNA的长读长策略,其本质都是对“拷贝”而非“原件”进行测序:RNA需先被逆转录为cDNA,再经PCR扩增或建库。这一过程会引入模板切换、3′端偏好、GC含量偏差以及扩增噪音等不可逆偏倚;更重要的是,传统方法无法在单个天然RNA分子上同时读取“序列、修饰与poly(A)尾”三层信息。
在此背景下,一篇发表于 iMeta (影响因子33.2)的综述文章《Nanopore direct RNA sequencing and the epitranscriptome: Advances in mapping native RNA landscapes》系统梳理了纳米孔DRS的技术原理、实验流程、计算方法与转化应用。该文明确指出:DRS并非要取代现有转录组方法,而是作为一种互补的、单分子分辨率平台,为整合转录组、表观转录组与poly(A)尾动态提供入口。
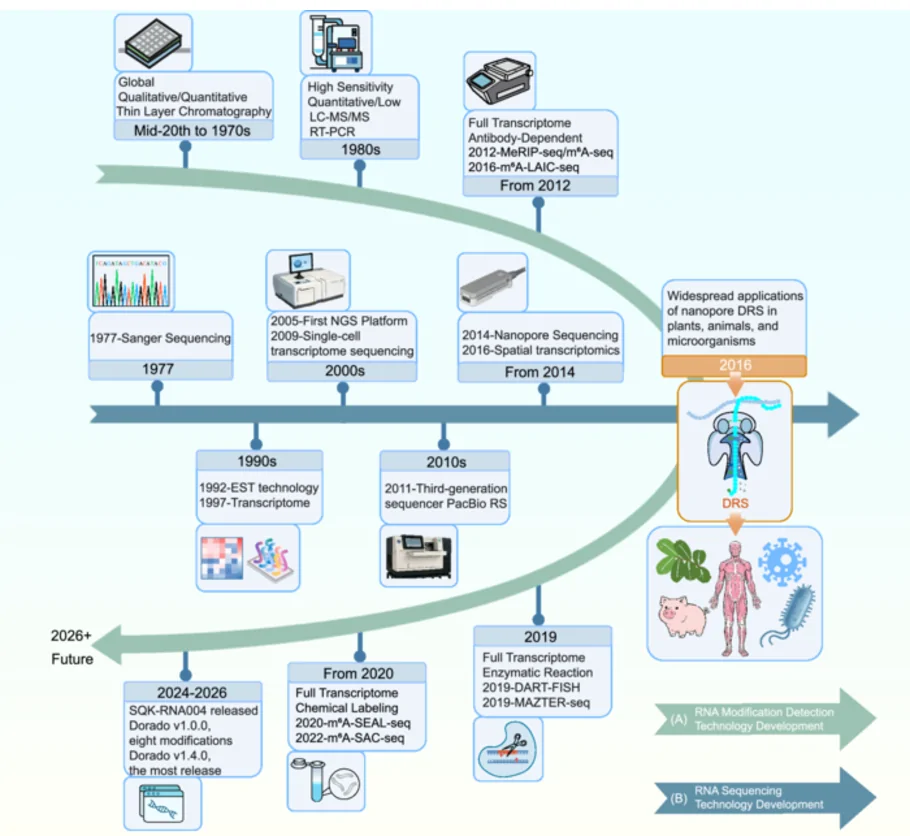
Figure 1 RNA测序与RNA修饰技术重大创新的时间线。(A) RNA修饰分析的演变,从早期的色谱方法(20世纪中叶),到基于LC-MS/MS和RT-PCR的方法(1980年代),随后是2012年起基于抗体的全转录组图谱绘制(例如MeRIP-seq/m6A-seq、m6A-LAIC-seq),以及更近期的酶学和化学标记策略(例如DART-seq、MAZTER-seq、m6A-SEAL-seq、m6A-SAC-seq)。采用SQK-RNA004化学的纳米孔DRS实现了性能提升,当与Dorado软件v1.0.0及以上版本结合时,可检测多达八种不同的RNA修饰。(B) RNA测序技术的发展,包括Sanger测序(1977年)、下一代测序(2000年代)、长读长平台(例如PacBio RS;2010年代)和纳米孔测序(自2014年起)。标出了自2016年起牛津纳米孔DRS的引入。DART-seq,RNA靶向邻近脱氨测序;DRS,直接RNA测序。LC-MS/MS,液相色谱-串联质谱联用;m6A-LAIC-seq,N6-甲基腺苷水平与异构体表征测序;m6A-SAC-seq,N6-甲基腺苷位点特异性碱裂解测序;m6A-SEAL-seq,通过酶辅助碱连接的N6-甲基腺苷测序;m6A-seq,N6-甲基腺苷测序;MAZTER-seq,MazF核酸内切酶辅助的RNA m6A分析测序;MeRIP-seq,甲基化RNA免疫沉淀测序;PacBio RS,太平洋生物科学实时测序;RT-PCR,逆转录聚合酶链反应。研究背景:为什么“直接读RNA”如此重要
要理解DRS的价值,需要先看清传统RNA测序的瓶颈。短读长RNA-seq虽能实现全基因组范围的转录本定量,却受限于读长,在长转录本、复杂可变剪接或串联重复区域,往往无法通过组装恢复单分子水平的全长结构。长读长cDNA测序虽改善了异构体解析能力,但仍以逆转录产物为模板。
文章指出,cDNA策略存在三大偏倚来源:其一,模板层面——逆转录、PCR或建库中的偏好被永久嵌入数据;其二,信息内容受限——传统RNA-seq只能借助化学/酶学富集或覆盖深度间接推断少数修饰(如m6A、m5C),无法在同一分子上直接同步读取序列、修饰和poly(A)尾;其三,可观测信息不完整——在疾病、应激或衰老条件下,复杂二级结构或修饰密集区域会差异化地影响逆转录效率,导致具有生物学意义的转录本被系统性低估。
与此同时,RNA修饰检测技术也从20世纪中期的纸层析、薄层层析,发展到LC-MS/MS、基于抗体的MeRIP-seq/m6A-seq(分辨率约100–200 nt),再到近单碱基的PA-m6A-seq、miCLIP,以及2018年后兴起的非抗体策略(GLORI-seq、m6A-SEAL-seq、MAZTER-seq、DART-seq等)。但这些方法通常只针对特定修饰类型,且读数仍锚定在cDNA层面,难以在单RNA分子分辨率上同时解析全长结构、修饰图谱与poly(A)尾特征。
核心发现:DRS如何实现“一次测量、多层读出”
纳米孔DRS的核心原理是:在电场驱动下,带负电的单链RNA由马达蛋白控制,以3′→5′方向穿过嵌入膜中的生物纳米孔。当约5个核苷酸占据纳米孔狭窄收缩区时,会阻碍离子电流,产生特征性电流变化;不同k-mer组合对应不同“指纹”信号,设备实时记录并由深度学习算法(basecalling)解码为序列。
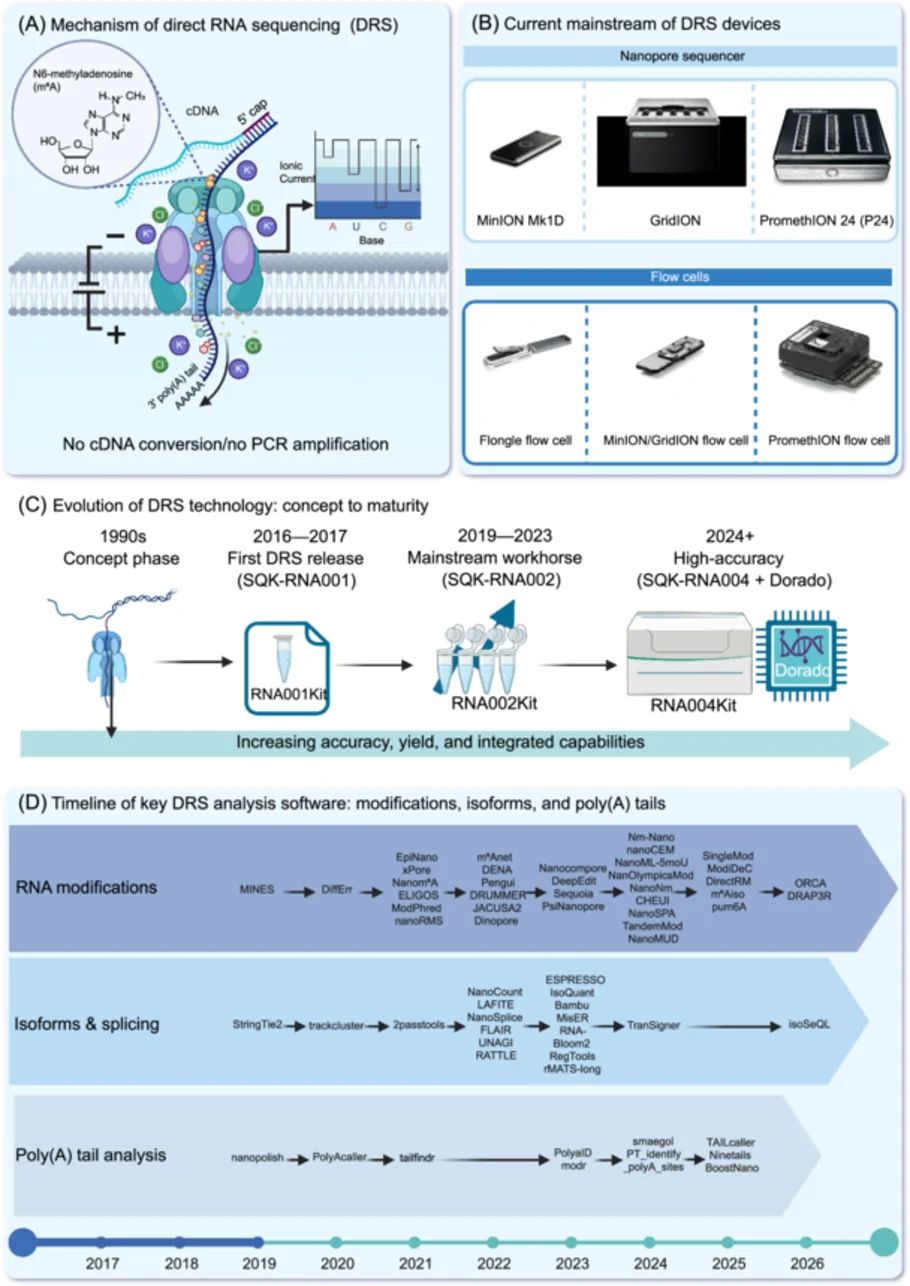
Figure 2 DRS技术、平台和软件概述。(A) DRS原理。天然poly(A)+ RNA分子直接通过生物纳米孔测序,无需cDNA合成或PCR扩增。当RNA在施加电压下穿过纳米孔时,离子电流中核苷酸特异性的扰动使得碱基识别以及对诸如m6A等RNA修饰的直接检测成为可能。(B) 当前支持DRS的主流纳米孔平台和耗材,包括MinION Mk1D、GridION和PromethION仪器,以及相应的流动槽。(C) DRS技术从早期概念基础到成熟、相对较高准确性工作流程的演变。关键里程碑包括首个商业DRS试剂盒(SQK-RNA001;2016−2017)、SQK-RNA002作为主流主力产品的建立(2019−2023),以及近期将SQK-RNA004化学与Dorado碱基识别整合的进展(2024+),从而提高了准确性、通量和功能性。(D) 为DRS数据分析开发的主要计算工具的时间线,重点介绍了用于RNA修饰检测、异构体和剪接分析以及poly(A)尾长度估计的方法。这一进展说明了从2017年至今DRS生物信息学生态系统的快速扩张和日益复杂化。m6A,N6-甲基腺苷。使用BioRender创建。Li, Y. (2026) https://BioRender.com/d8phpl6。由于直接以天然RNA为模板,DRS无需逆转录和扩增,从根本上避免了上述偏倚。其关键优势在于可生成超越序列本身的多维数据:RNA上的化学修饰(如m6A、Ψ、m5C、肌苷等)会微妙改变离子电流信号,从而被计算识别;而mRNA 3′端poly(A)尾由重复相同核苷酸组成,在电流中呈低方差信号,通过分析该区段信号并校正穿孔速度,即可估算每个转录本的poly(A)尾长度(如nanopolish-polya等工具)。
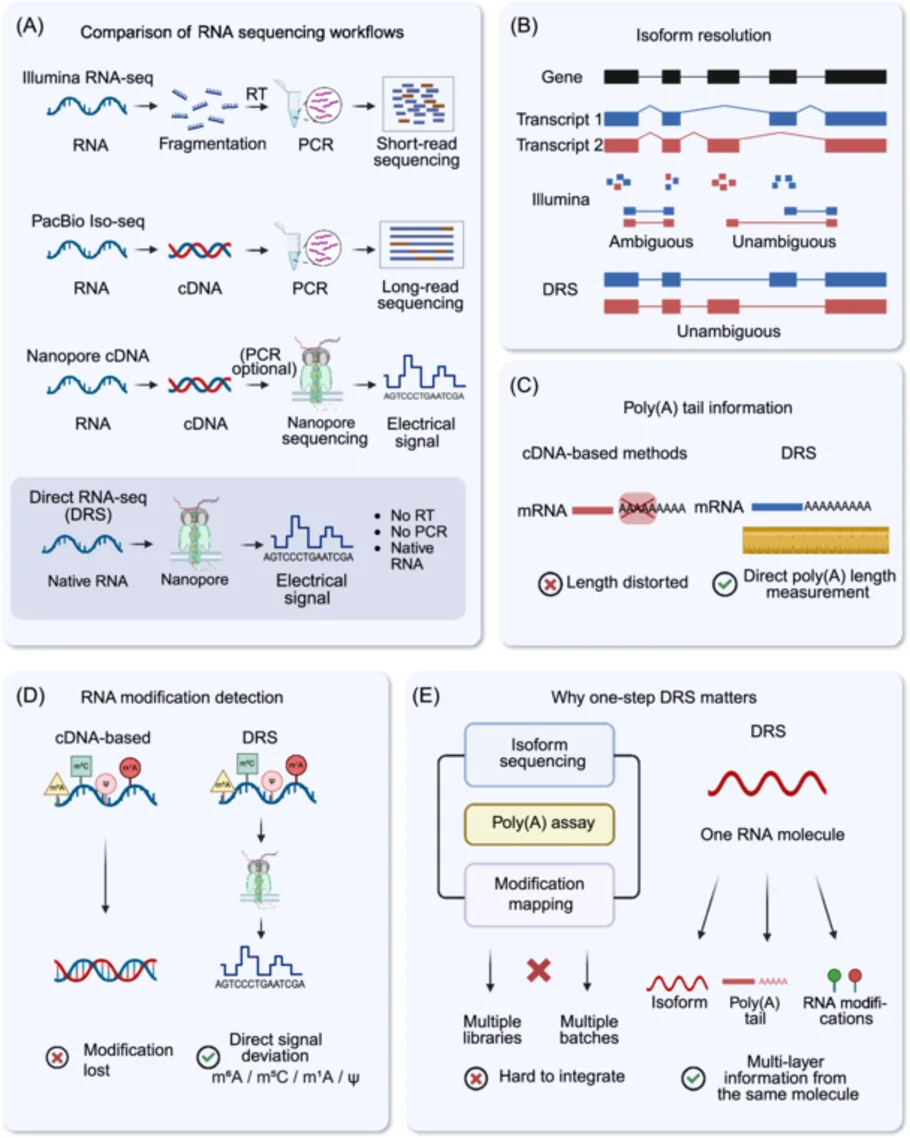
文章对比了不同RNA测序策略的工作流与捕获特征:DRS可在同一分子上同步捕获多种RNA修饰、全长转录本架构、可变剪接模式以及poly(A)尾特征,从而提供转录组与表观转录组调控的整合视图。
Figure 3 RNA测序策略与DRS捕获特征的比较。(A) 主要RNA测序模式的工作流程比较。Illumina RNA-seq需要RNA片段化、后续的逆转录和PCR扩增以产生短读长。PacBio Iso-Seq和纳米孔cDNA测序从cDNA模板提供长读长,通常包含逆转录并经常进行PCR扩增。相反,纳米孔DRS直接通过纳米孔对天然RNA分子进行测序,产生用于碱基识别的电流信号,无需逆转录或PCR,从而最大限度地减少了与转化和扩增相关的偏差。(B) 异构体分辨率。短读长RNA测序有时产生的读长对应多个转录本异构体,导致归属不清。相比之下,长读长方法,尤其是DRS,能更清晰地重建和量化全长异构体及剪接位点连接。(C) 关于Poly(A)尾的信息。基于cDNA的文库构建可能会因RT/PCR错误而使感知到的poly(A)尾长度产生偏差,而DRS利用天然RNA信号和/或读长特征促进poly(A)尾长度的直接测量。(D) RNA修饰的检测。在cDNA合成中,许多RNA修饰在所得cDNA序列中并未保留,但DRS保留了天然的化学修饰,这些修饰可从纳米孔电流中与修饰相关的变异(例如m6A、Ψ、m1A和m5C)推断出来。(E) 单步DRS的合理性。通过探询单个RNA分子,DRS可以同时确定异构体身份、poly(A)尾特征和修饰特征,因此与需要不同检测和批次的方法相比,增强了整合的、多层次的转录组和表观转录组研究。cDNA,互补DNA;m5C,5-甲基胞嘧啶;PCR,聚合酶链反应;RT,逆转录;Ψ,假尿苷。使用BioRender创建。Li, Y. (2026) https://BioRender.com/i6hbowb。在技术演进方面,DRS概念可追溯至1989年David Deamer提出的“让单链核酸穿过纳米孔读取序列”的设想;1990年代Kasianowicz等观察到α-溶血素孔中的离子电流阻断事件,Bayley等发展出“随机传感”方法。ONT于2005年成立后,工程化改造CsgG蛋白推出R9系列纳米孔。2016年12月,ONT向少量研究者提供首个DRS试剂盒(SQK-RNA001);2017年4月正式开放,同年5月London Calling会议展示初步结果;2018年ONT团队在 Nature Methods 发表首个全面DRS研究,证明酵母mRNA全长测序及从电信号直接检测RNA修饰的可行性。
此后,SQK-RNA002在2019–2023年成为主流方案,显著提升数据产量与稳定性;2023年推出、2024年全面商业化的SQK-RNA004化学,通过重新设计纳米孔与优化马达蛋白,在保持相似错误谱的同时将准确率提升至约98%(F1分数96%–99%,而SQK-RNA002约为90%–94%),并增加读长输出。配合Dorado v1.0.0及以上版本,最新化学可识别多达8种不同的RNA修饰。
方法亮点:从实验设计到计算流程的系统优化
该综述不仅讲“能测什么”,也厘清“哪些仍依赖模型推断”“哪些场景最适合DRS”以及“需要何种基准验证”。在实验层面,文章总结了针对不同RNA生物型(mRNA、rRNA、tRNA、circRNA、miRNA及非poly(A)转录本)的建库策略、质控流程与测序优化实践。
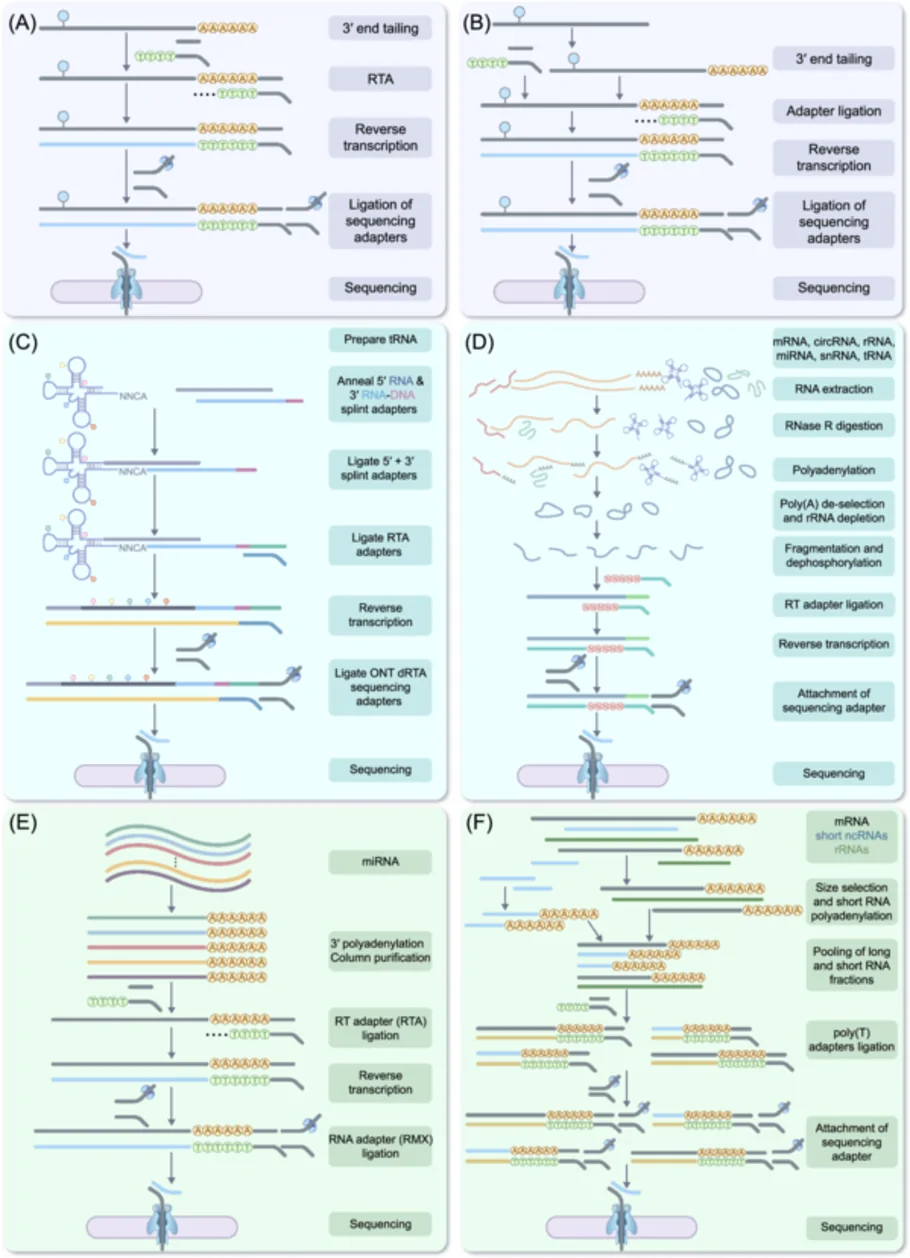
Figure 5 不同RNA类别的DRS实验流程示意图。(A) mRNA DRS工作流程,展示了3′端加尾(如需要)、接头连接、在3′端引发的逆转录、测序接头连接和纳米孔测序。(B) rRNA工作流程,包括初级rRNA转录本加工、rRNA成熟,以及直接RNA方法、接头连接和测序。(C) tRNA工作流程,展示了5′和3′夹板接头与成熟tRNA的退火、逆转录接头连接、cDNA合成、ONT接头连接及后续的纳米孔测序。(D) circRNA工作流程,涉及总RNA提取、RNase R消化以富集环状分子、聚腺苷酸化及去除残留线性RNA、接头连接、逆转录,以及上样circRNA-cDNA杂交体进行测序。(E) miRNA工作流程,其中小RNA被富集,进行3′聚腺苷酸化,连接至逆转录和RNA接头,转化为RNA-cDNA杂交体并进行测序。(F) 非poly(A) RNA工作流程,描述了长、短非聚腺苷酸化转录本的并行处理、片段大小选择、合并、poly(T)接头连接,以及构建与DRS兼容的文库。cDNA,互补DNA;circRNA,环状RNA;miRNA,微小RNA;mRNA,信使RNA;ONT,牛津纳米孔技术公司;rRNA,核糖体RNA;tRNA,转运RNA。以mRNA DRS工作流为例,包括(如需)3′端加尾、接头连接、3′末端引发的逆转录、测序接头连接等步骤;其他RNA类别亦有相应示意流程。文章强调合成spike-in对照(如ERCC RNA和可定制IVT RNA)为定量、修饰检测和poly(A)推断提供基准真值。
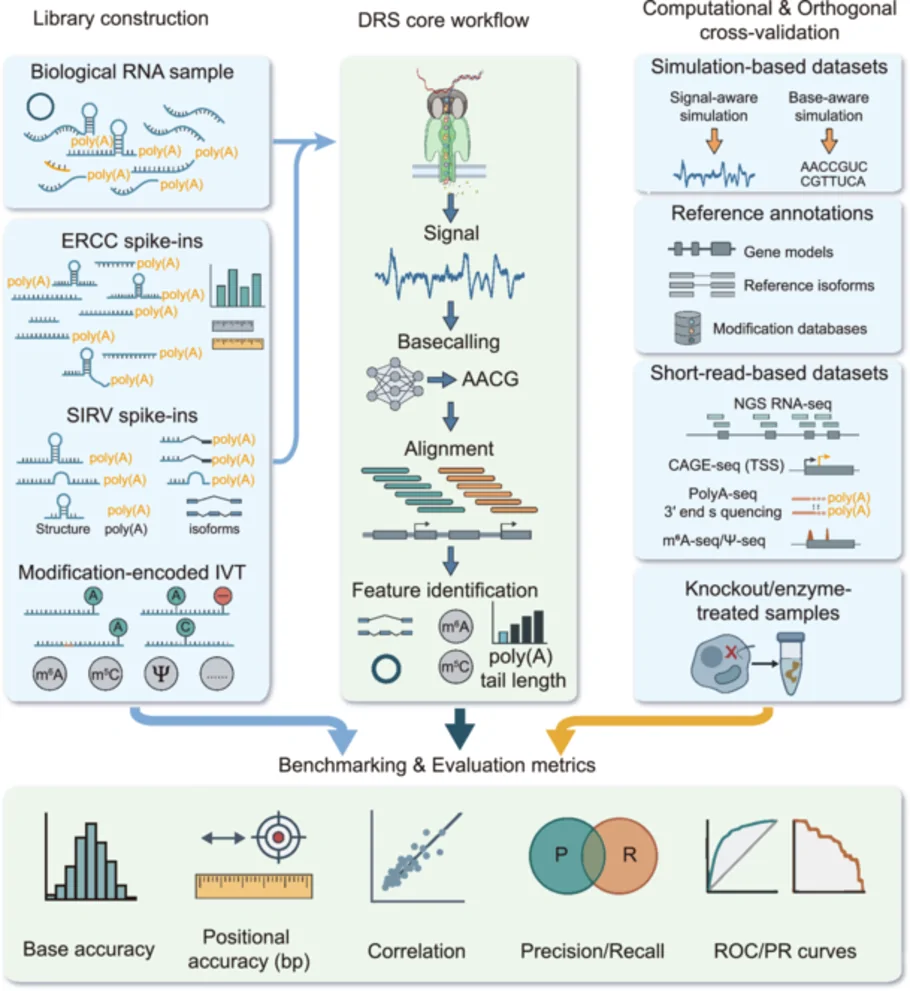
Figure 8 DRS的实验设计与多层基准测试框架。合成掺入对照,包括ERCC RNA和可定制的IVT RNA,为基准测试定量、异构体结构、转录本边界和poly(A)尾长度提供了明确的基准真值。携带位点特异性或基序定义的RNA修饰的修饰编码IVT掺入物,使得修饰识别算法的监督训练和评估成为可能。基于模拟的数据集通过实现对序列和信号水平特征的完全可编程、可扩展的基准测试,进一步补充了实验对照。正交生物学资源,包括经过整理的基因组注释、表观转录组数据库、匹配的短读长测序以及5′/3′端分析检测,为转录本结构和修饰识别提供了独立验证。遗传和酶学扰动,例如书写器/擦除器敲除或修饰特异性化学处理,为DRS衍生的特征提供了因果验证。总之,这些资源支持从原始离子电流和碱基识别准确性到比对、转录本重建、定量和RNA修饰检测的多层基准测试,从而实现对DRS方法的稳健、可重复且基于生物学的评估。ERCC,外部RNA控制联盟;IVT,体外转录。在计算层面,文章梳理了从原始数据到生物学结论的端到端流程:涵盖RNA修饰检测、转录本重建、异构体定量、poly(A)尾长度推断以及多层联合分析框架。文中区分了“直接纳米孔信号”与“计算推断结果”,以定义不同结论的置信水平,并强调读数的基准测试与正交验证。
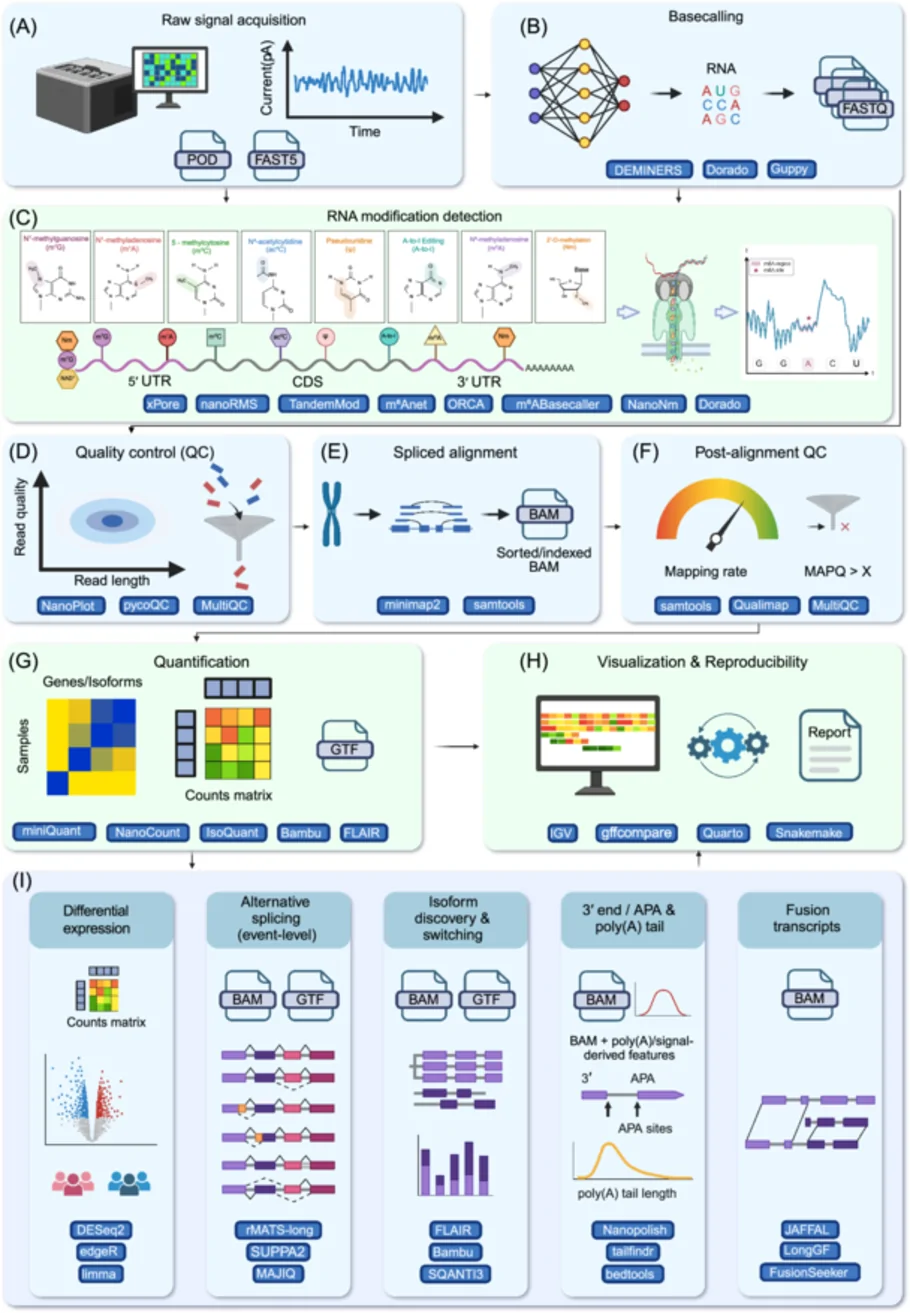
Figure 6 DRS数据分析及下游应用的端到端计算工作流程。典型DRS生物信息学流程的示意图,展示了从原始数据到生物学解释的过程,每个分析阶段对应的生物信息学工具以蓝色框突出显示。(A) 以天然纳米孔测序文件格式(POD/FAST5)获取和存储原始离子电流信号。(B) 碱基识别将原始离子电流信号转换为标准FASTQ格式的核苷酸序列。(C) 从跨越必需转录本区域(5′ UTR、CDS和3′ UTR)的信号水平特征中识别RNA修饰,涵盖普遍的表观遗传标记和编辑事件(例如m6A、m5C、Ψ、ac4C、m1A、m7G、A-to-I、Nm)。(D) 比对前质量控制,以评估基本测序变量,如读长和读长质量。(E) DRS读长与参考基因组/转录组的剪接比对,产生比对后的读长,处理成分选和索引的BAM文件。(F) 比对后质量控制,以总结基因组比对参数,包括总体比对率和MAPQ分数分布。(G) 由标准GTF指导的转录本和基因水平定量,生成用于后续统计分析的基因/异构体计数矩阵。(H) 数据可视化和可重复的科学报告,包括基于基因组浏览器的转录组特征检查和用于分析可重复性的有序工作流程管理。(I) 由长读长DRS数据促进的多样化下游生物学分析,包括转录本差异表达分析、事件水平的可变剪接分析、从头异构体发现、异构体转换分析、3′端使用/可变聚腺苷酸化分析、poly(A)尾长度估计,以及从全长RNA读长中检测融合转录本。ac4C,N4-乙酰胞苷;A-to-I,腺苷到肌苷的RNA编辑;BAM,二进制比对图;CDS,编码序列;GTF,基因转移格式;m1A,1-甲基腺苷;m5C,5-甲基胞嘧啶;m6A,N6-甲基腺苷;m7G,7-甲基鸟苷;MAPQ,比对质量;Nm,2′-O-甲基化;UTR,非翻译区;Ψ,假尿苷。使用BioRender创建。Li, Y. (2026) https://BioRender.com/0zmrexv。常用可视化示例包括使用ggsashimi展示可变剪接与转录本覆盖度的sashimi图等。文章还提供实际操作案例以促进可重复分析。
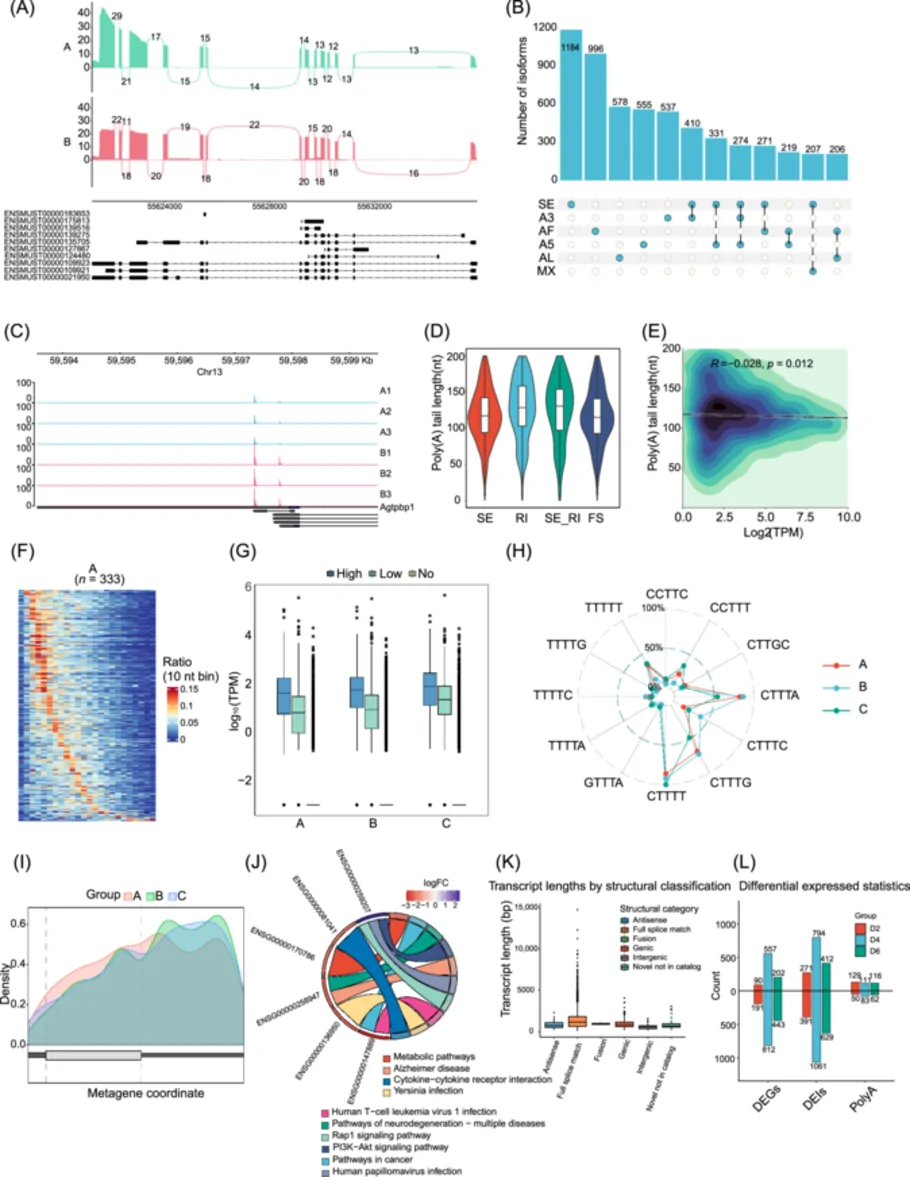
Figure 7 DRS研究中常用分析可视化示例。(A) 使用ggsashimi对可变剪接和转录本覆盖度进行可视化。Sashimi图显示了一个代表性基因的外显子覆盖度和剪接位点使用情况,下方显示了带注释的转录本异构体。(B) AS异构体的组合模式。UpSet图显示了涉及不同可变剪接类型及其组合的异构体数量。(C) 由DRS数据揭示的、在代表性基因处APA的IGV可视化。(D) 与不同AS事件类型相关的poly(A)尾长度分布。(E) 显示转录本丰度与poly(A)尾长度关联的二维密度图。x轴表示以Log2(TPM)表示的转录本丰度,y轴显示poly(A)尾长度(nt)。颜色强度表示数据点的密度。(F) 对于每组(以A组为例,n = 333个转录本),x轴表示poly(A)尾长度,每行对应一个转录本,颜色表示该转录本在每个长度区间中读长的比例。(G) RNA甲基化状态与转录本表达之间的关系。x轴表示样本组(A–C),y轴显示转录本丰度(log10(TPM))。(H) A、B和C组中富集程度最高的假尿苷(Ψ)相关基序。每个轴对应一个基序,径向值表示其出现百分比,彩色线条代表各组。(I) A、B和C组中mRNA特征上Ψ位点密度的修饰谱。x轴表示从5′ UTR穿过CDS到3′ UTR的相对元基因坐标,y轴表示Ψ位点密度。曲线对应不同的样本组。(J) 将选定基因与富集通路联系起来的弦图。颜色标尺(logFC)表示基因表达变化的方向和幅度,而缎带说明哪些基因对每个通路有贡献。(K) SQANTI3结构转录本类别间的转录本长度分布。x轴表示SQANTI3结构类别,y轴显示转录本长度。(L) 跨时间点差异表达和poly(A)变化的总结。柱状图显示差异表达基因(DEGs)、差异编辑异构体(DEIs)和具有差异poly(A)位点的转录本的数量。A3,可变3′剪接位点;A5,可变5′剪接位点;AF,可变第一外显子;AL,可变最后外显子;APA,可变聚腺苷酸化;AS,可变剪接;DEGs,差异表达基因;DEIs,差异编辑异构体;FS,移码;IGV,整合基因组学查看器;logFC,log2倍数变化;MX,互斥外显子;nt,核苷酸;RI,内含子滞留;SE,外显子跳跃;SE_RI:组合的外显子跳跃/内含子滞留事件;TPM,每百万转录本;Ψ,假尿苷。此外,DRS可作为多组学整合的枢纽:在基因组学层面提供异构体解析的转录模型并关联调控元件活性;在更广泛层面上,将异构体、poly(A)尾与RNA修饰整合进结构化数据框架。
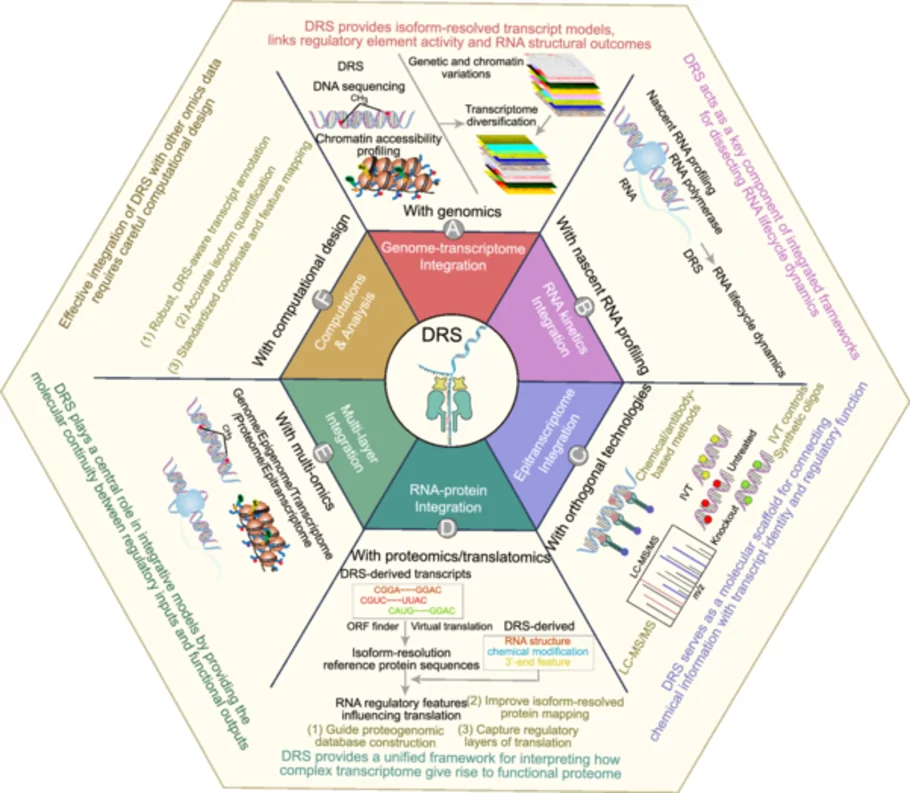
Figure 9 纳米孔直接RNA测序作为多组学整合的中心枢纽。(A) 在与基因组学的整合中,DRS提供异构体解析的转录本模型,将调控元件活性与RNA结构结果联系起来。(B) 在与新生RNA分析的整合中,DRS作为解析RNA生命周期动态的综合框架的关键组成部分。(C) 在与RNA化学修饰正交技术的整合中,DRS作为连接化学信息与转录本身份及调控功能的分子支架。(D) 在与蛋白质组学的整合中,DRS为解释复杂转录组如何产生功能蛋白质组提供了统一的框架。(E) 在与多组学的整合中,DRS通过提供调控输入与功能输出之间的分子连续性,在整合模型中发挥核心作用。(F) DRS与其他组学数据的有效整合需要仔细的计算设计。应用意义:从基础发现到精准医学
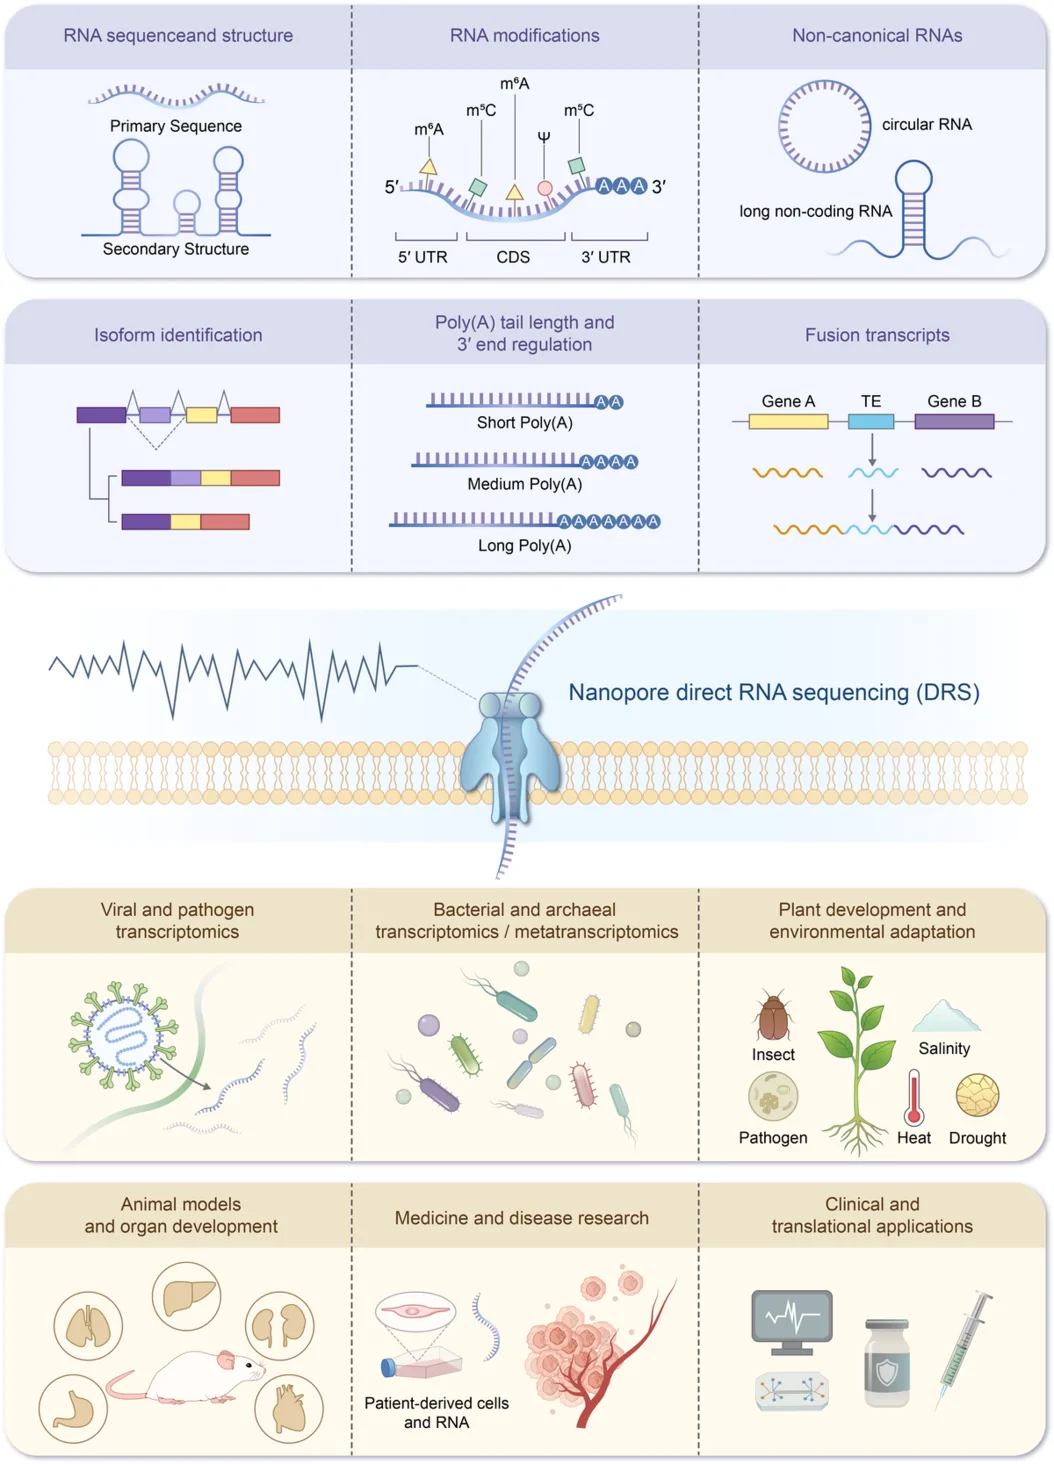
DRS的优势与生物学应用可概括为:解析复杂转录组、刻画协同的表观转录组调控、识别疾病相关RNA特征。例如在植物研究中,2020年一项拟南芥转录组研究显示,DRS可揭示mRNA中的剪接异构体、替代多聚腺苷酸化(APA)位点选择以及m6A修饰模式;在人类样本中,早期SQK-RNA001应用已展示同时评估转录本多样性、poly(A)尾长度和RNA修饰的潜力。
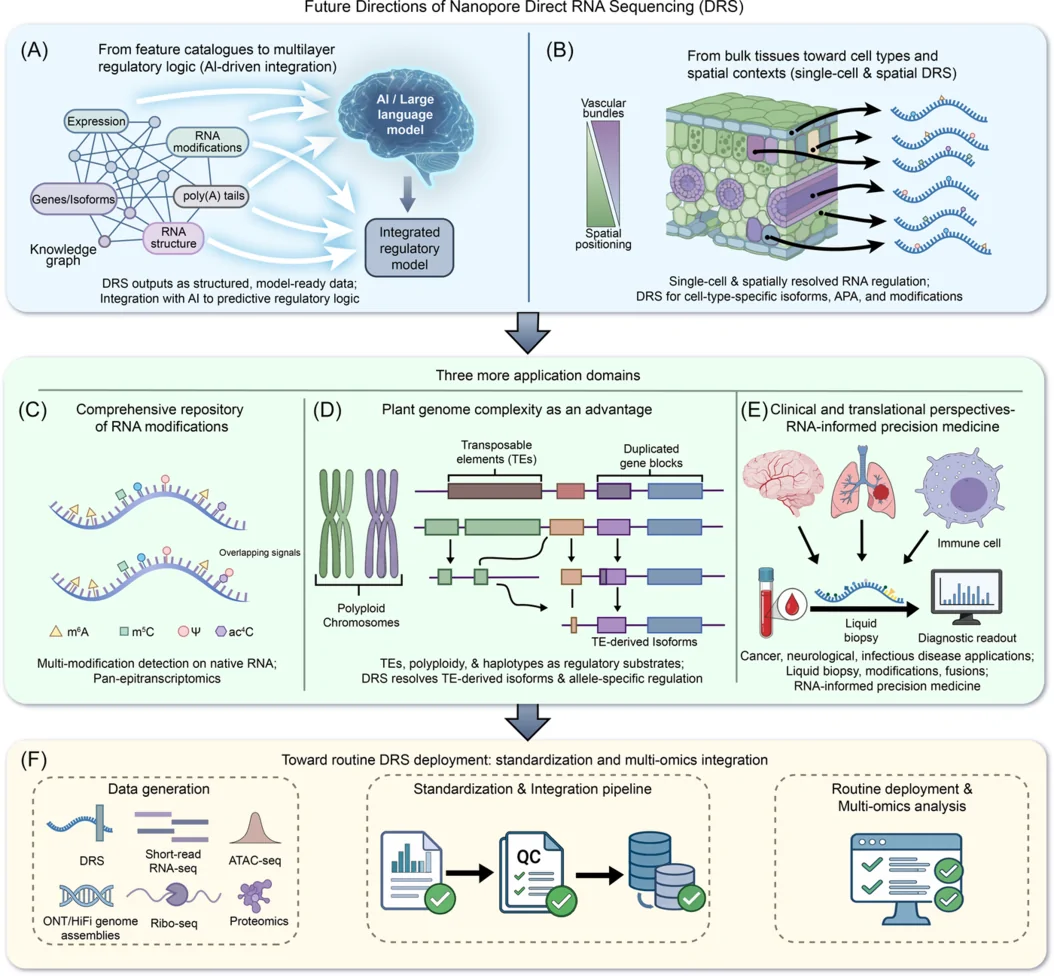
Figure 4 DRS的优势与生物学应用。纳米孔DRS主要优势和应用案例的示意图总结。TE:转座元件。文章也讨论了当前技术挑战与未来方向,特别是在多组学整合、以及在植物与动物研究及精准医学中更广泛部署DRS的前景。展望未来,DRS正从“特征目录”走向“多层调控逻辑”:将异构体、poly(A)尾和RNA修饰整合为兼容结构化数据框架的资源。
Figure 10 纳米孔DRS应用展望。(A) 从特征目录到多层调控逻辑:DRS将异构体、poly(A)尾和RNA修饰整合到与AI和知识图谱模型兼容的结构化数据框架中。(B) 从批量到单细胞和空间背景:新兴策略旨在解析细胞类型特异性的RNA调控。(C) 扩展表观转录组学:超越单一标记的多修饰检测使得整合的RNA状态分析成为可能。(D) 基因组复杂性即机遇:DRS解析TE衍生的异构体和单倍型特异性调控。(E) 临床转化:工作流程协调与多组学整合支持可扩展的研究和基于RNA的精准医疗。(F) 标准化与多组学整合构成了DRS常规化和可扩展部署的基础。AI,人工智能。总体而言,这篇综述把纳米孔DRS从生物物理原理、实验设计、数据处理到算法创新与转化应用串联成完整链条,为RNA生物学研究者提供了一份面向实践、可操作的参考。它提醒我们:在解读DRS数据时,应清楚区分直接电信号与计算推断,结合基准测试与正交验证,才能让“天然RNA全景图”真正服务于机制解析与临床探索。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。