文章中心
了解、体验、感悟、分享——汇聚平台使用教程与科研动态。
新AI模型EXIT实现金属有机框架“样品感知”属性预测
原文:Multimodal Transformer for Sample-Aware Prediction of Metal-Organic Framework Properties.
期刊:ACS central science(影响因子 10.4) | PubMed | PMC 全文(含 PDF)
在药物递送、生物成像、气体储存与分离等生物医学与材料交叉领域,金属有机框架(Metal–Organic Frameworks,简称 MOFs)是一类极具前景的多孔材料。它们由金属节点与有机连接体组装而成,拥有极高的比表面积和可调控的孔道结构,因此被广泛用于催化、吸附、传感以及潜在的药物载体设计。
过去十余年,机器学习已经成为预测 MOFs 性质的重要工具。无论是沸石、聚合物还是无机固体,研究者都习惯让模型学习“材料表示 → 某一标量性质”的映射关系,例如从晶体结构预测甲烷吸附量、热分解温度或比表面积。在理想化的模拟数据库中,这种策略非常自然:每一种材料都有明确定义的结构,并在理想条件下计算出对应性质。
然而,一旦走进真实实验世界,问题就出现了。实验测量并不是针对一个抽象的“材料标签”进行的,而是针对一个具体合成出来的样品。即使是同一种名义上的 MOF,比如 MOF-5、HKUST-1 或 UiO-66,不同论文报道的比表面积、孔体积也可能相差很大。造成差异的原因包括结晶度不同、相纯度不同、缺陷浓度不同、活化处理方式不同,以及合成历史带来的样品状态差异。
换句话说,机器学习预测与实验测量之间的偏差,并不只是噪声,而往往是一个“表示问题”:如果模型输入只编码了组成、拓扑或理想晶体结构,那么样品层面的差异就被迫挤进残差误差里,而无法被显式表达。这正是当前 MOFs 性质预测从“框架感知”走向“样品感知”的核心难点。
核心发现:EXIT 把 XRD 变成“样品指纹”
为了解决这一难题,研究团队在 ACS Central Science(影响因子 10.4)上发表了题为 Multimodal Transformer for Sample-Aware Prediction of Metal-Organic Framework Properties 的论文,提出了名为 EXIT(Experimental X-ray Diffraction Integrated Transformer,实验 X 射线衍射集成 Transformer)的多模态 Transformer 模型。
EXIT 的核心思想非常直观:不仅告诉模型“这个 MOF 是谁”,还要告诉模型“这个实际样品长什么样”。它同时接收两种输入:一种是 MOFid,用类语言格式编码 MOF 的理想化学身份,包括金属节点、有机连接体、拓扑和穿插结构;另一种是 X 射线衍射(XRD)图谱,提供实际样品的结晶状态信息,例如相组成、对称性、结晶度、晶畴尺寸、应变和择优取向等。
MOFid 被当作序列 token 输入,而 XRD 信号先经过一维卷积神经网络编码,再与 MOFid 序列共同嵌入,由 Transformer 编码器进行多模态融合。模型先在 100 万个假设 MOF 及其模拟 XRD 上进行预训练,学习可迁移表示;随后在下游任务中微调。
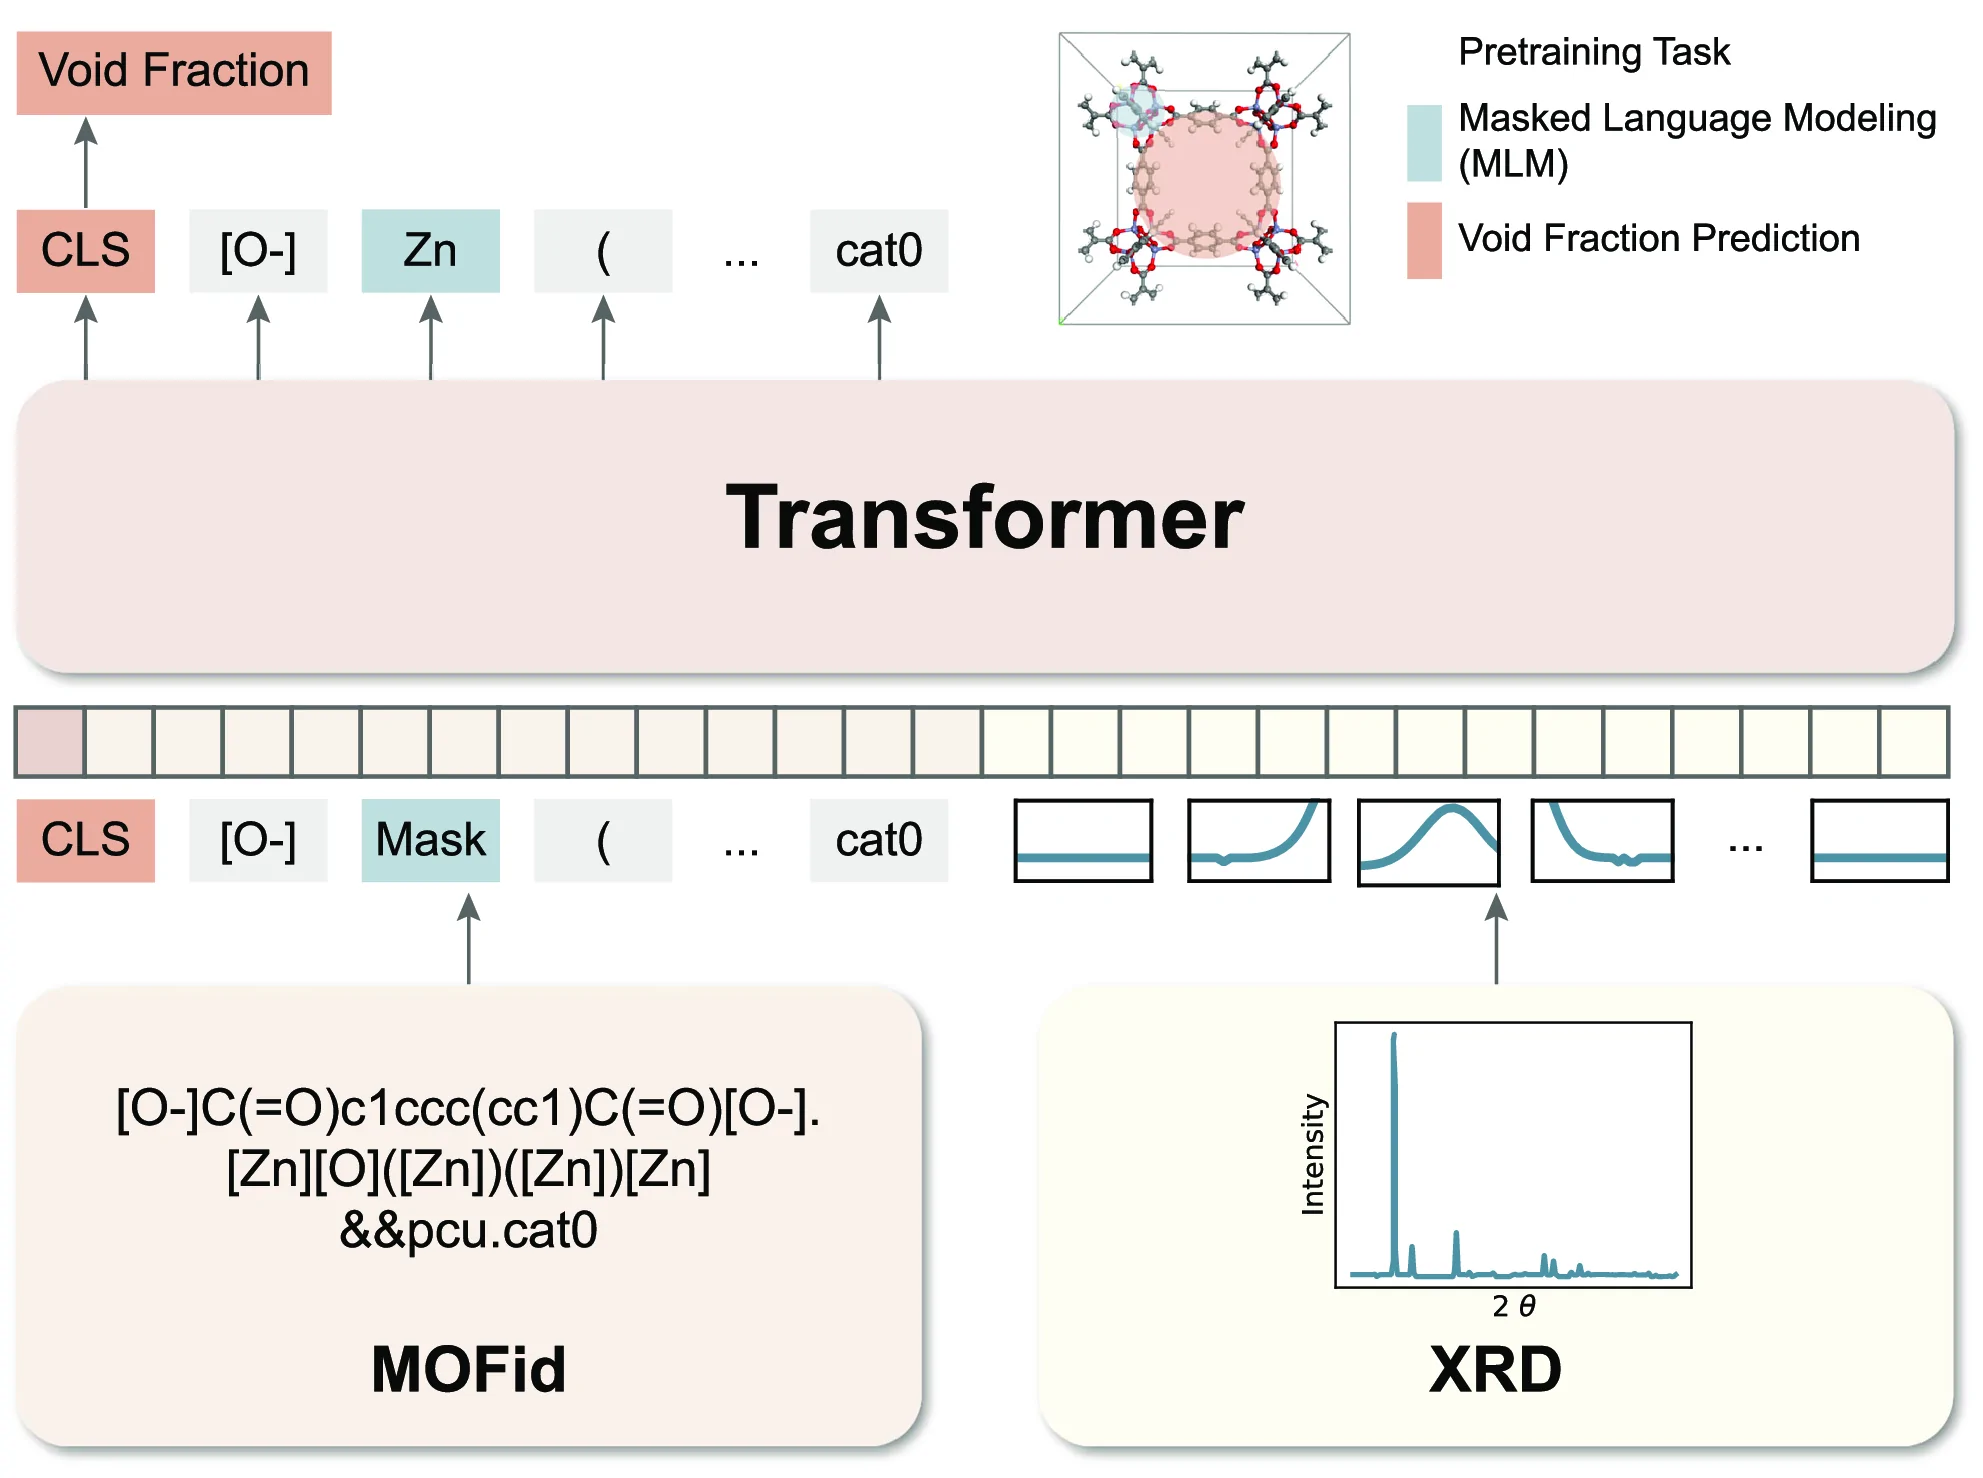
在模拟 XRD 的下游任务中,EXIT 展现了强大性能。对于热分解温度(TD)预测,预训练后的 EXIT 将平均绝对误差(MAE)从从零开始训练的 54.99 K 降到 44.58 K;对于 298 K、2.5 bar 下的 CH4 吸附量预测,MAE 从 0.30 mol kg–1 降到 0.17 mol kg–1。与已有基线模型相比,预训练 EXIT 在 TD 任务上取得最低 MAE,在 CH4 任务上性能与 MOFTransformer 相当。这说明多模态预训练为下游任务提供了有效初始化。
更关键的是,研究团队把模型推向了真实的实验数据。他们从文献中整理出实验 XRD 与性质配对的数据集:最终得到 311 条比表面积(BET,单位 m2 g–1)记录,覆盖 84 种 MOFs;以及 181 条总孔体积(PV,单位 cm3 g–1)记录,覆盖 49 种 MOFs。每一条都同时配有 MOFid 和实验 XRD 图谱。
当把“理想框架模拟 XRD”换成“样品特异性的实验 XRD”后,预测效果显著提升。比表面积预测的决定系数 R2 从 0.30 提升到 0.53,MAE 从 405 m2 g–1 降到 334 m2 g–1;孔体积预测的 R2 从 0.12 提升到 0.59,MAE 从 0.26 cm3 g–1 降到 0.22 cm3 g–1。九折交叉验证也一致显示,使用实验 XRD 的模型平均表现更好:SA 的 R2 为 0.45 ± 0.11,PV 为 0.47 ± 0.08,而仅用模拟 XRD 的对比模型分别只有 0.20 ± 0.10 和 0.12 ± 0.10。
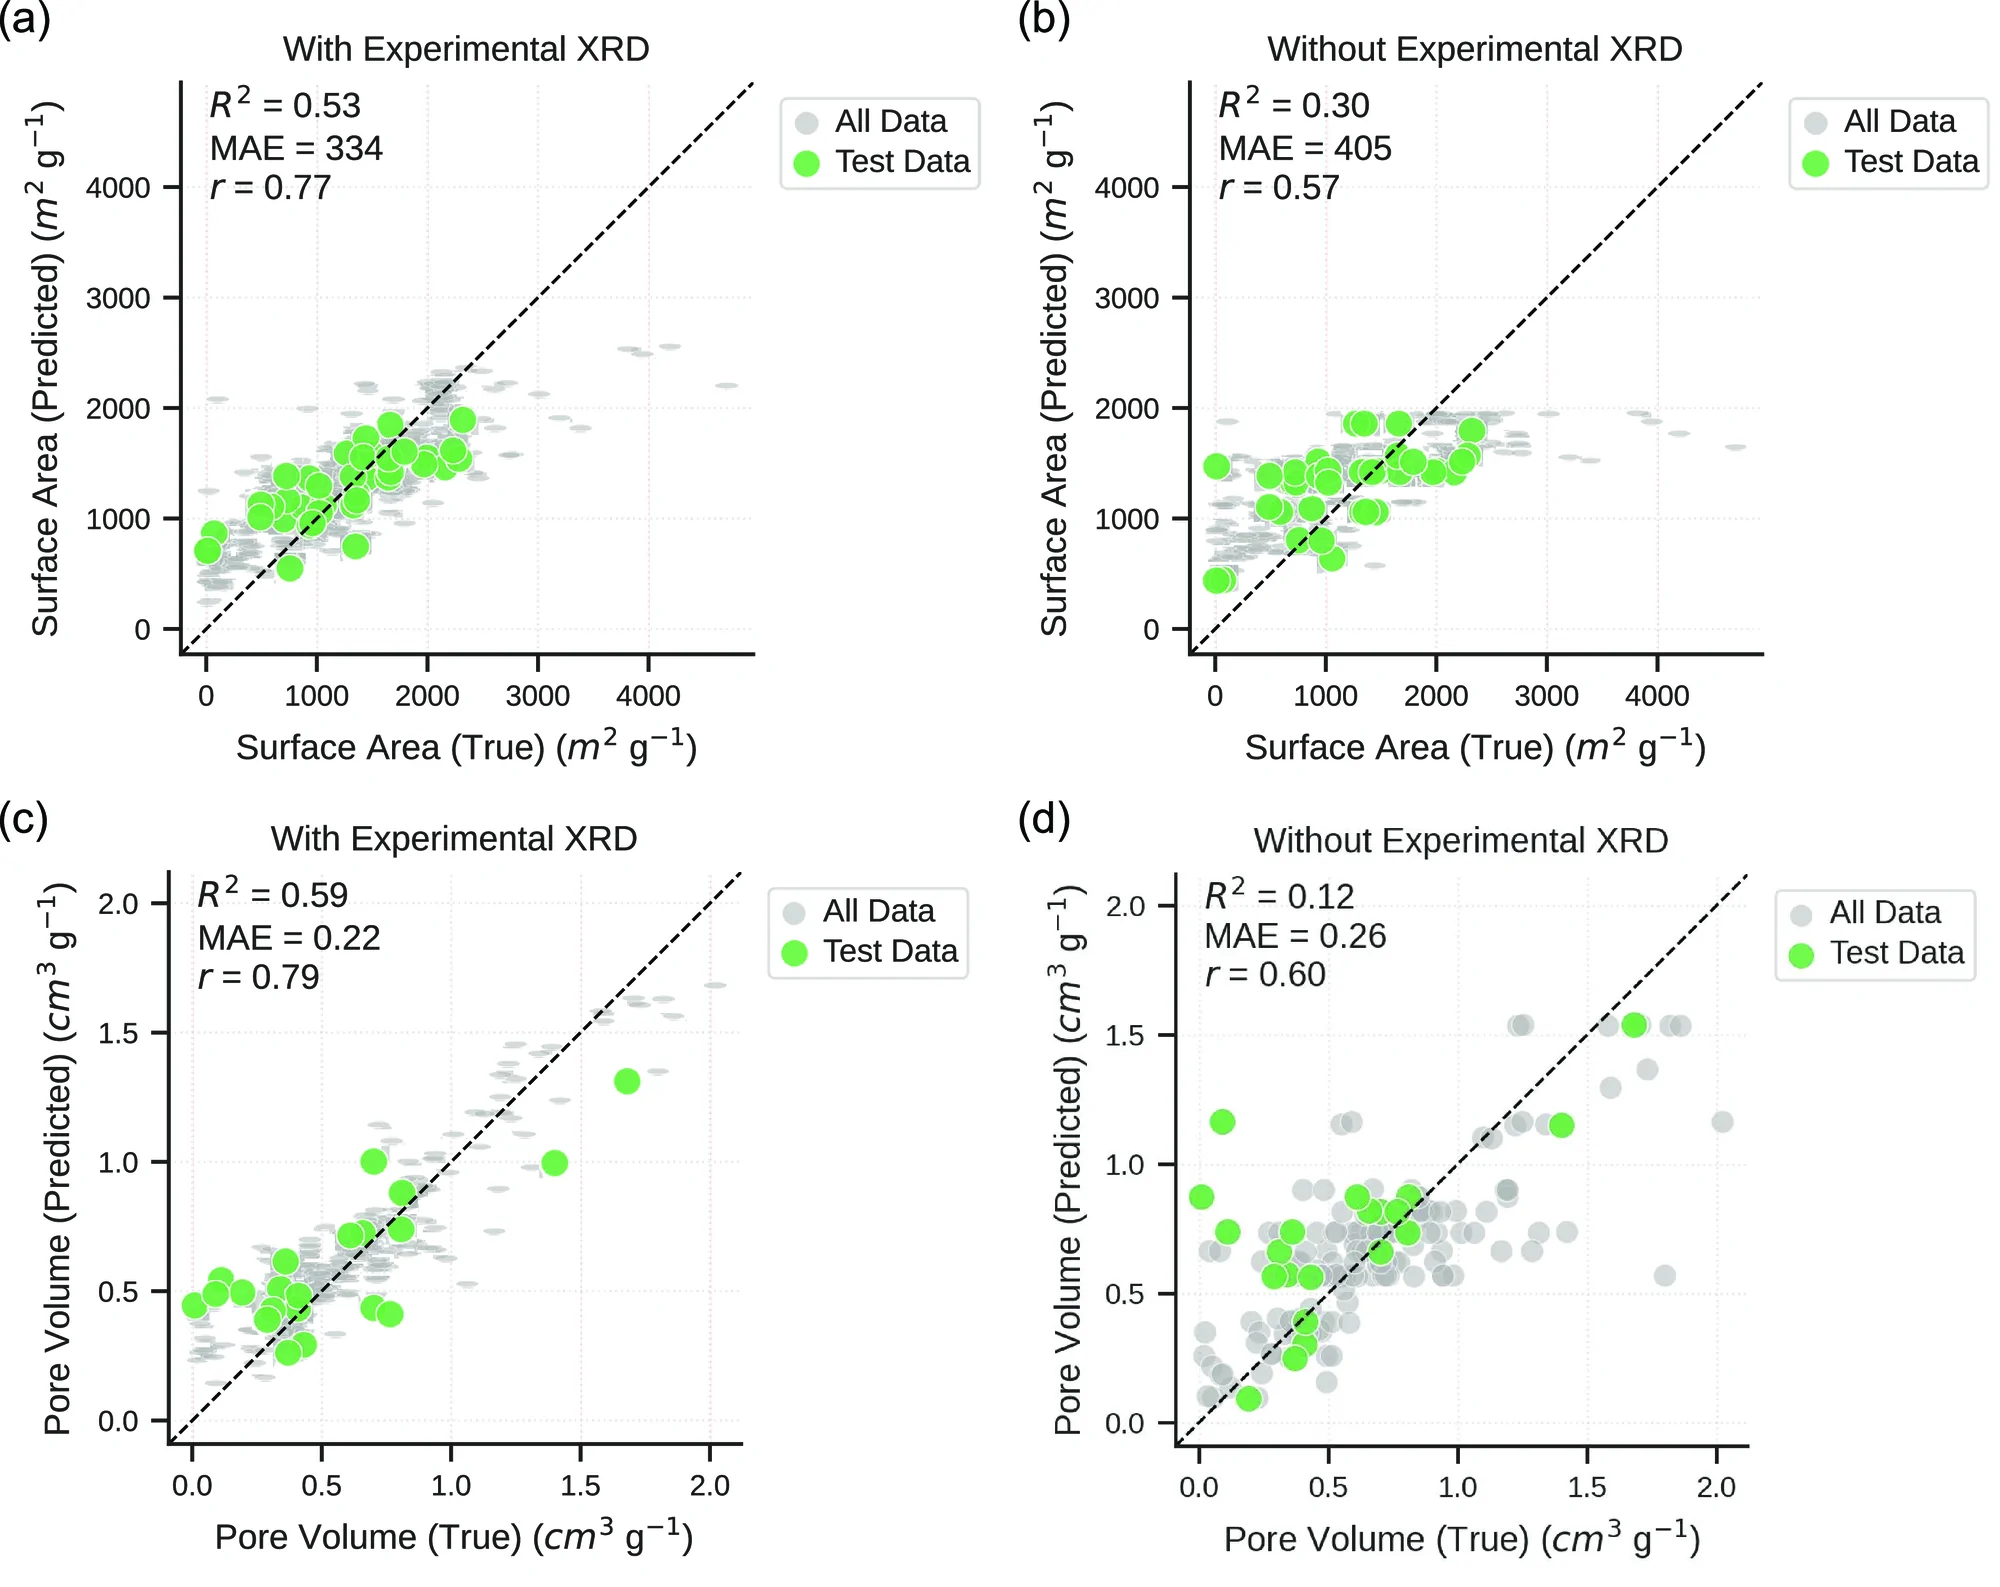
作者也谨慎指出,由于实验数据集规模较小且来自文献,存在合成、活化、测试流程的异质性,以及从论文图片中数字化 XRD 带来的不确定性;因此这些数值应被理解为“在当前文献数据集中,实验 XRD 含有超越 MOF 身份的预测信息”,而不是对所有 MOFs 和实验条件的泛化性能定论。
方法亮点:从文献中“挖”出实验 XRD 大数据
EXIT 的方法创新不仅在于模型结构,也在于如何构建实验数据集。研究团队先从先前工作 L2M3 文献数据库中的 69,183 篇 MOF 相关论文出发,利用 DOI 从 ACS 和 Elsevier 期刊下载图片,再用多模态大语言模型 GPT-5.4 识别含 XRD 图的图片。
如果一张图里有多个 XRD 面板,MatGD 工具会先把它们分离成单张图像,再数字化为数值衍射图谱,并经过基线校正、规则后处理和 0–1 归一化。MOF 身份主要由图例经 LLM 分配,并结合说明文字补充上下文。同时,实验 MOFs 通过 DOI–名称–refcode 配对映射到框架身份,从 CCDC 获取 CIF 结构、精修、去除游离溶剂,并用 MOFChecker 过滤无效条目;随后从整理好的 CIF 中提取 MOFid。
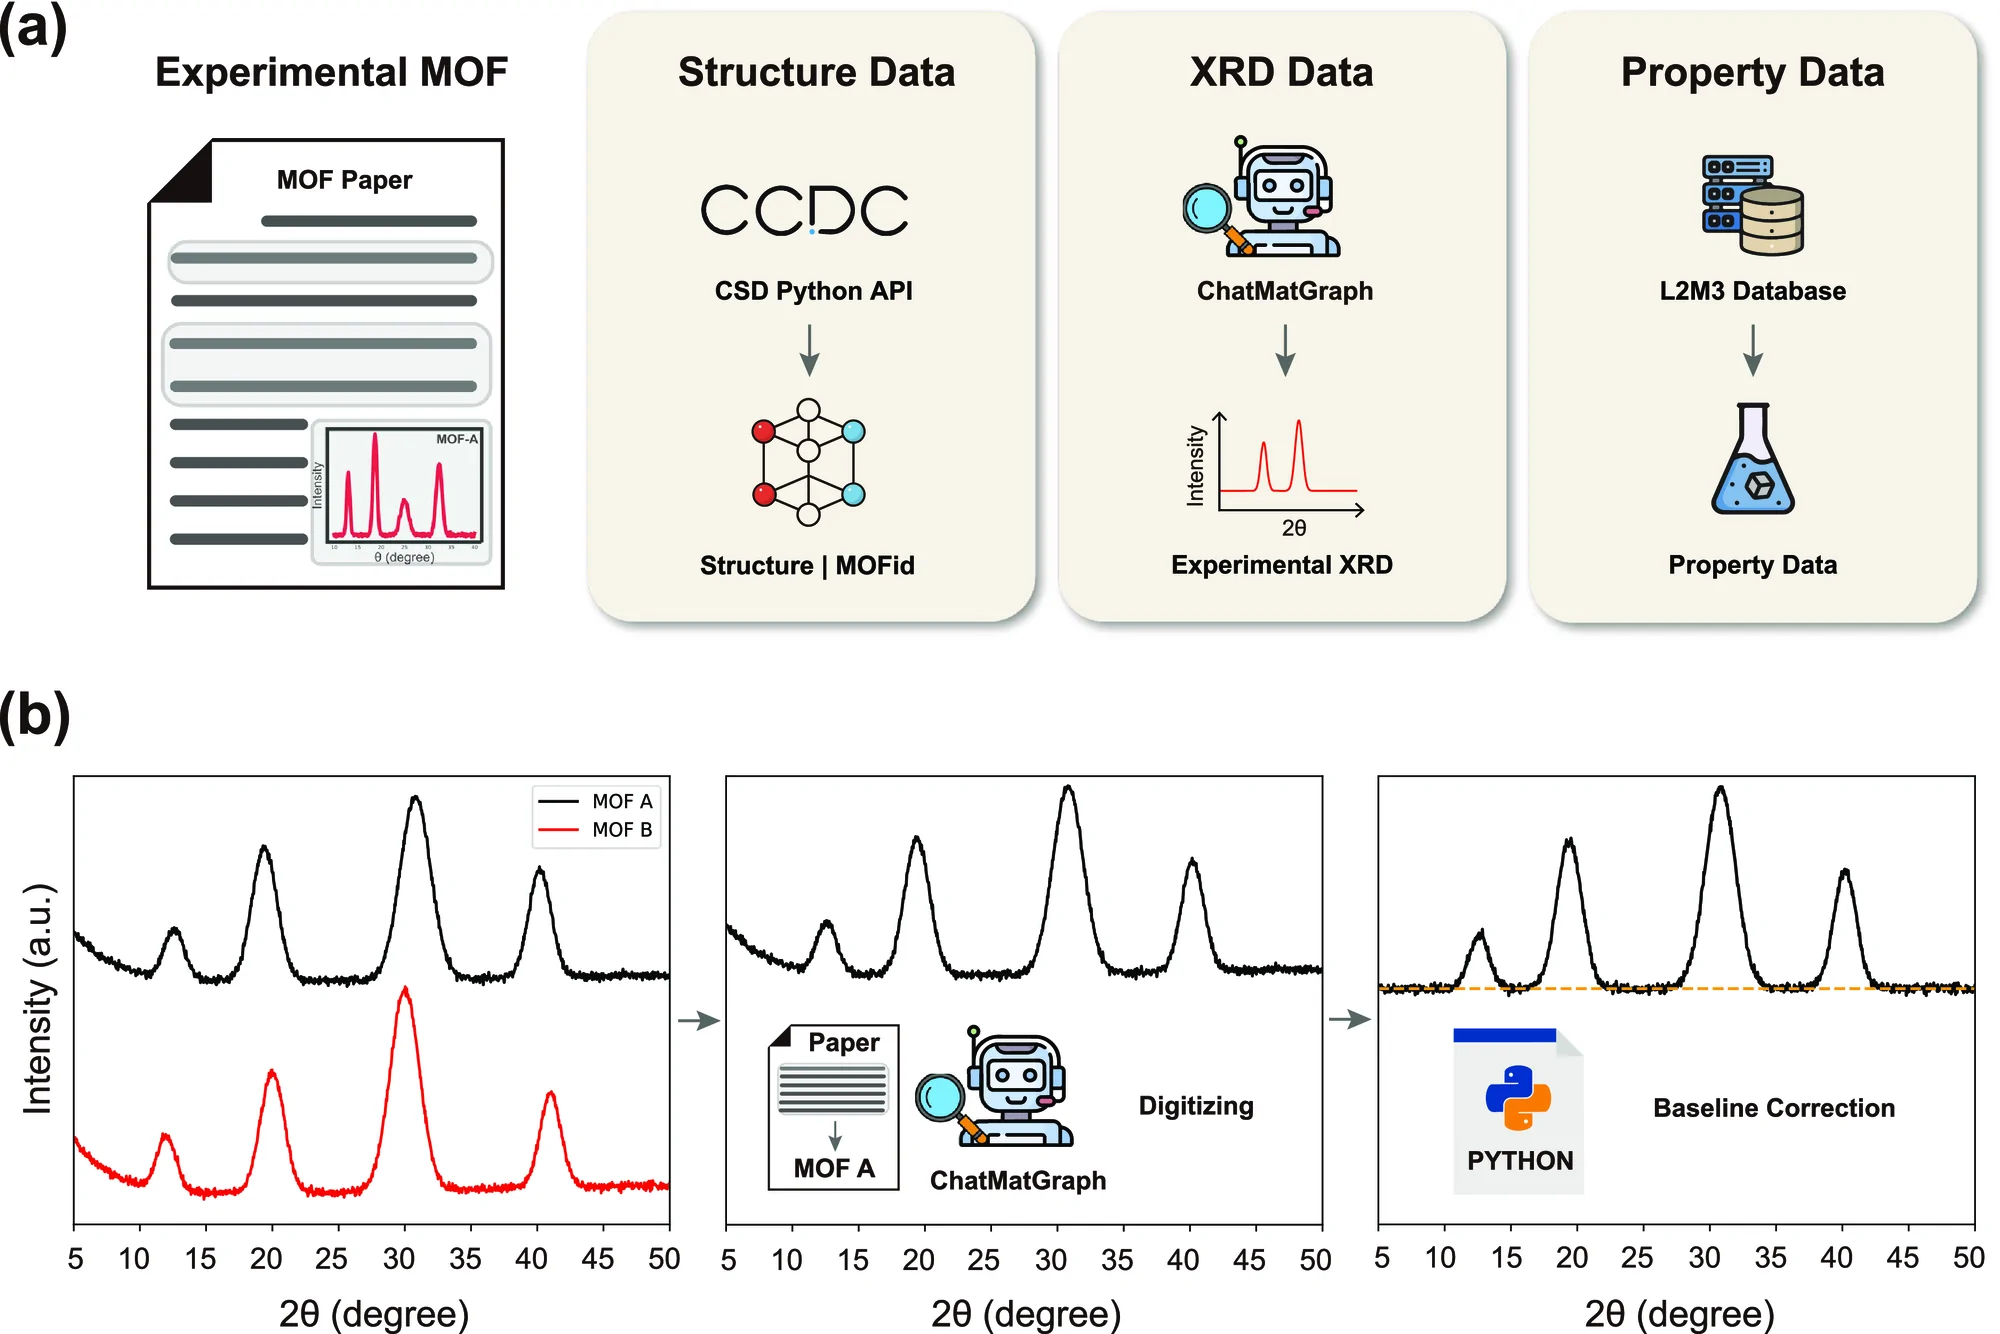
性质数据方面,比表面积只保留以 m2 g–1 报告的 BET 值,孔体积只保留以 cm3 g–1 报告的总孔体积值,并剔除非标准单位、范围值、列表或重复模糊条目。尽管初始文献库庞大,但要求同时具备 MOFid、可提取实验 XRD 和可用性质值,使得最终样本数量有限。
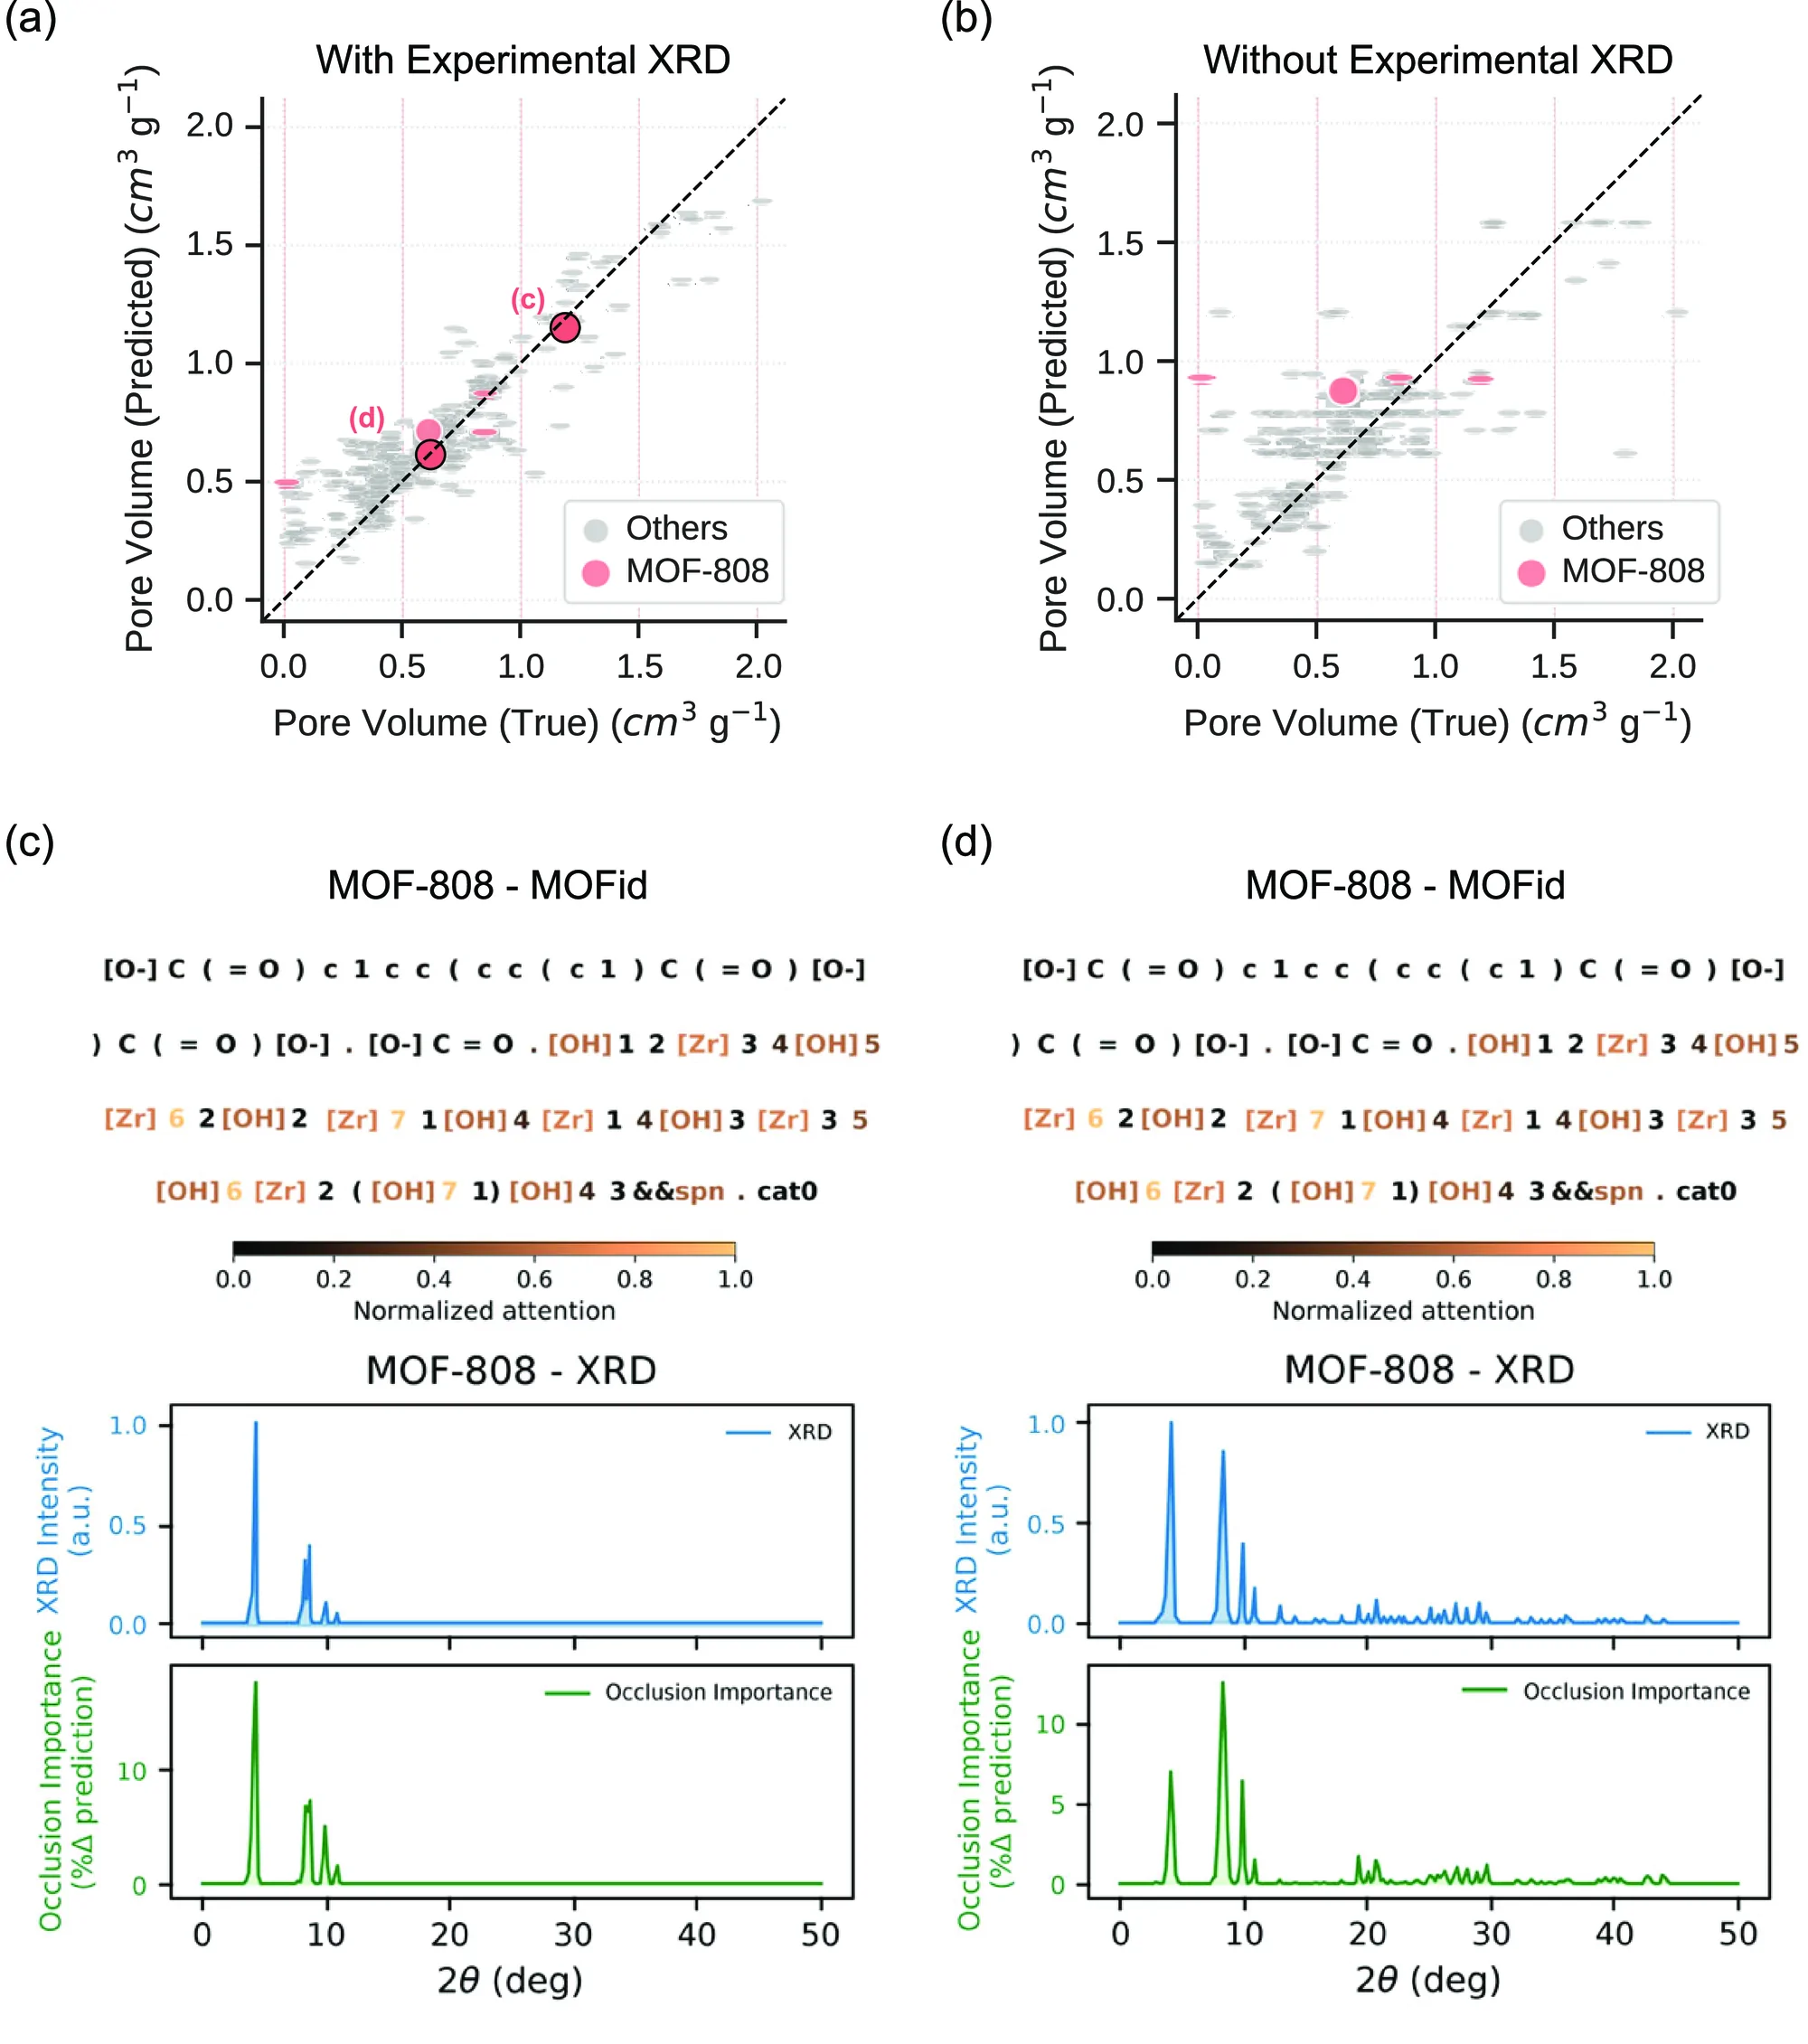
为了理解模型如何使用 XRD,作者做了注意力分析和遮挡敏感性分析。以两个 MOF-808 样品为例:它们共享相同 MOFid,但实测孔体积不同。当提供样品特异性实验 XRD 时,EXIT 给出不同预测;而换成理想框架的模拟 XRD 时,两个样品得到几乎相同的预测值约 0.87 cm3 g–1。进一步遮挡 XRD 的局部区间发现,对预测影响最大的位置分别在 2θ ≈ 4.3°(变化 17.52%)和 2θ ≈ 8.3°(变化 12.45%),都对应明显的低角度衍射峰。这说明模型确实在利用样品特有的衍射特征来区分同一框架下的不同样品。
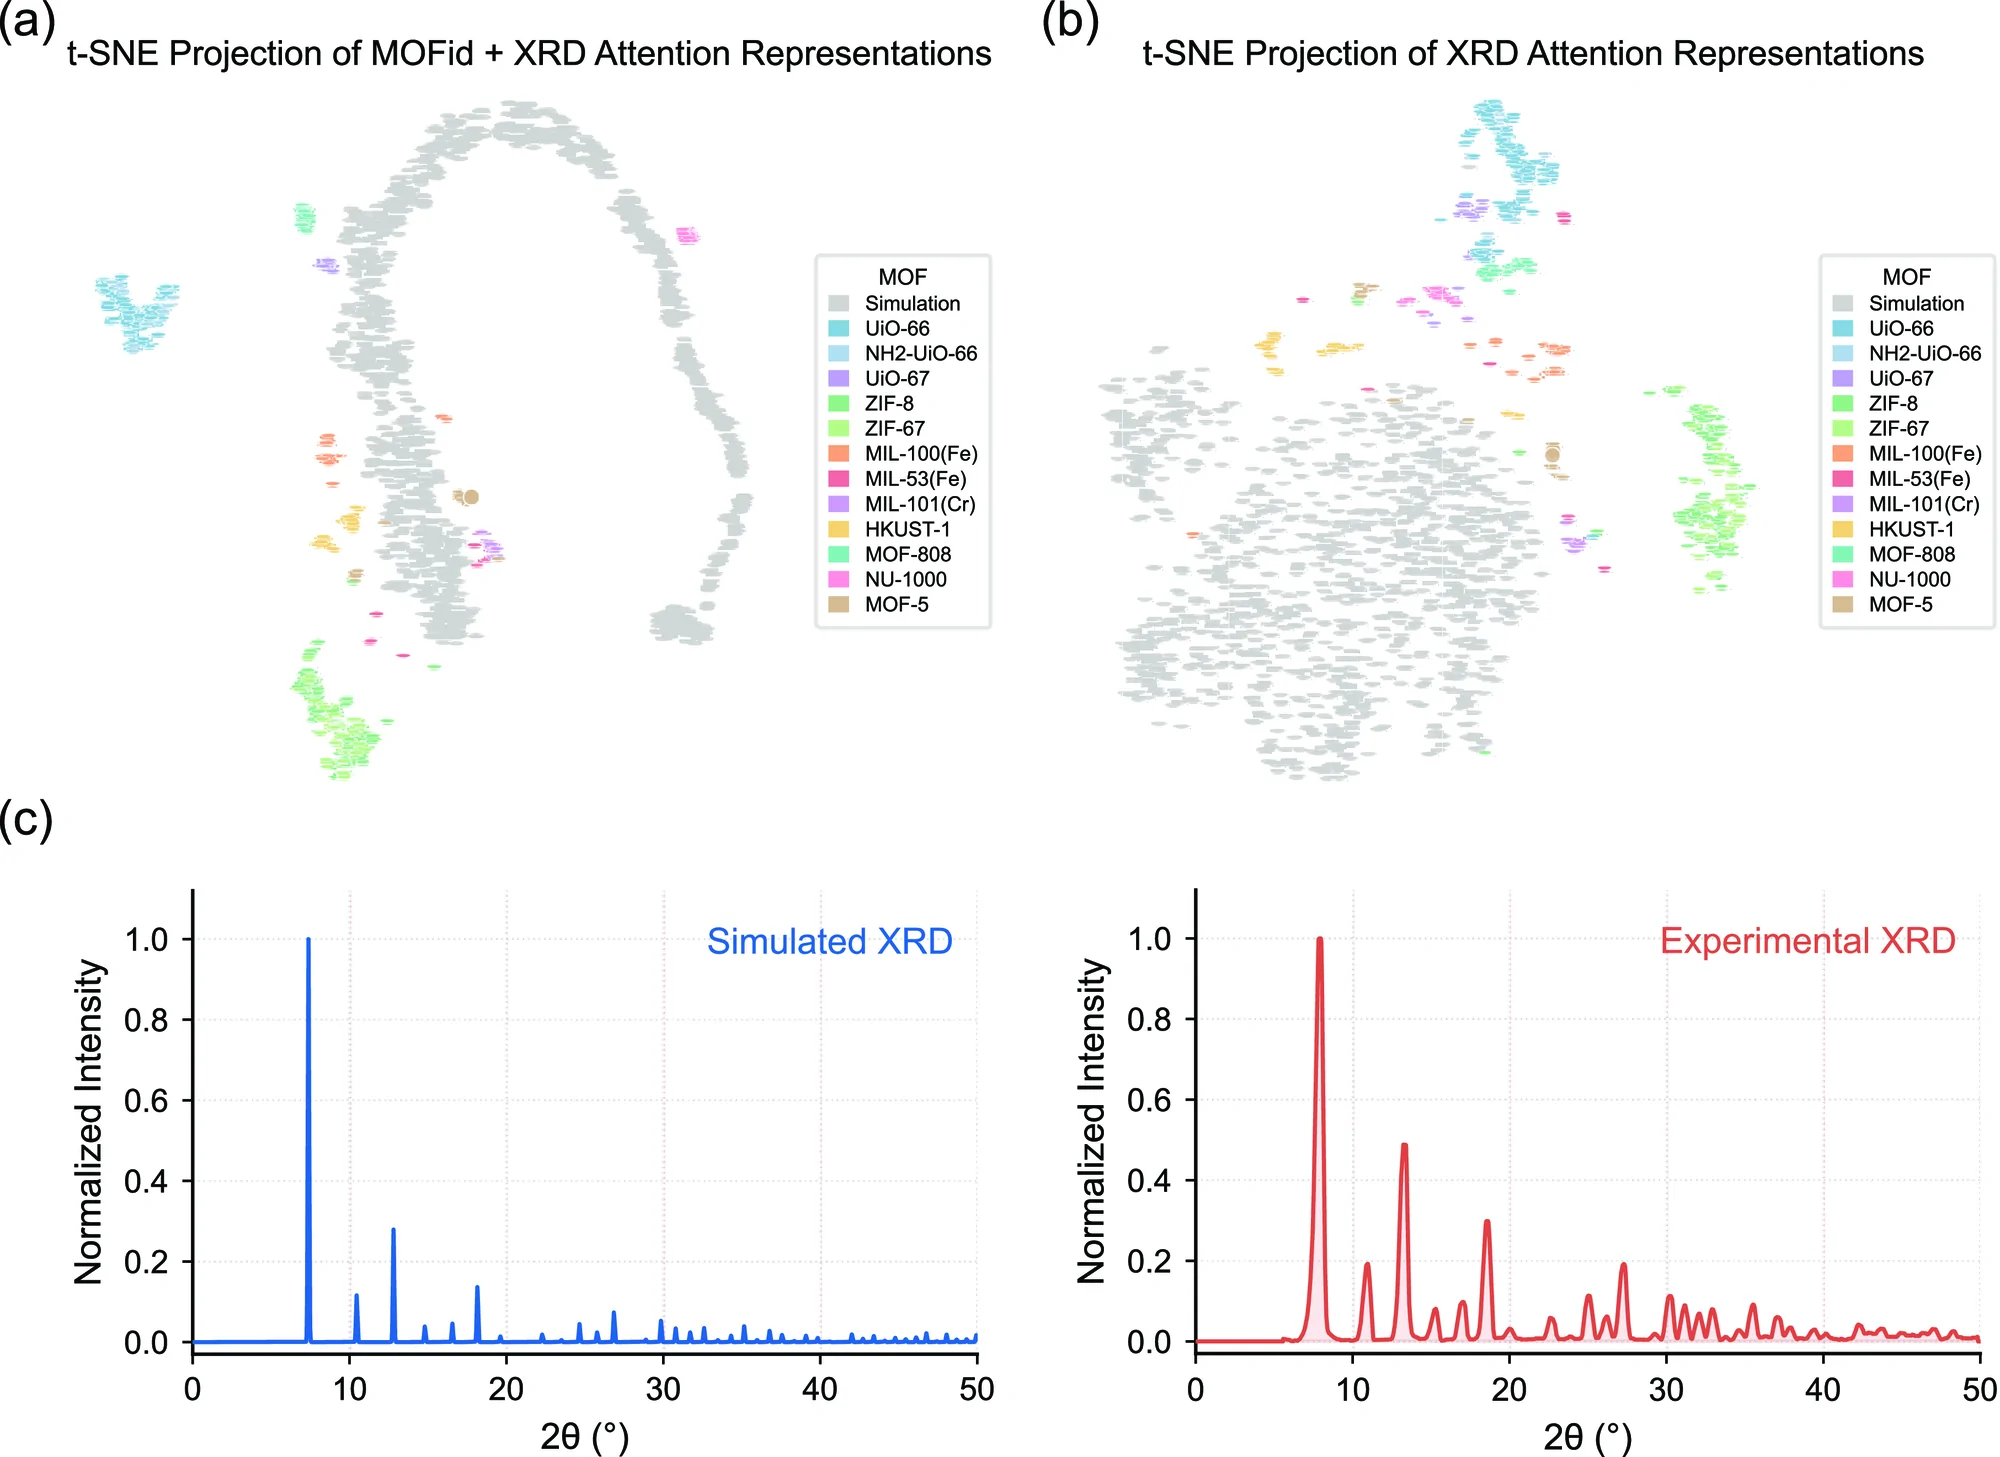
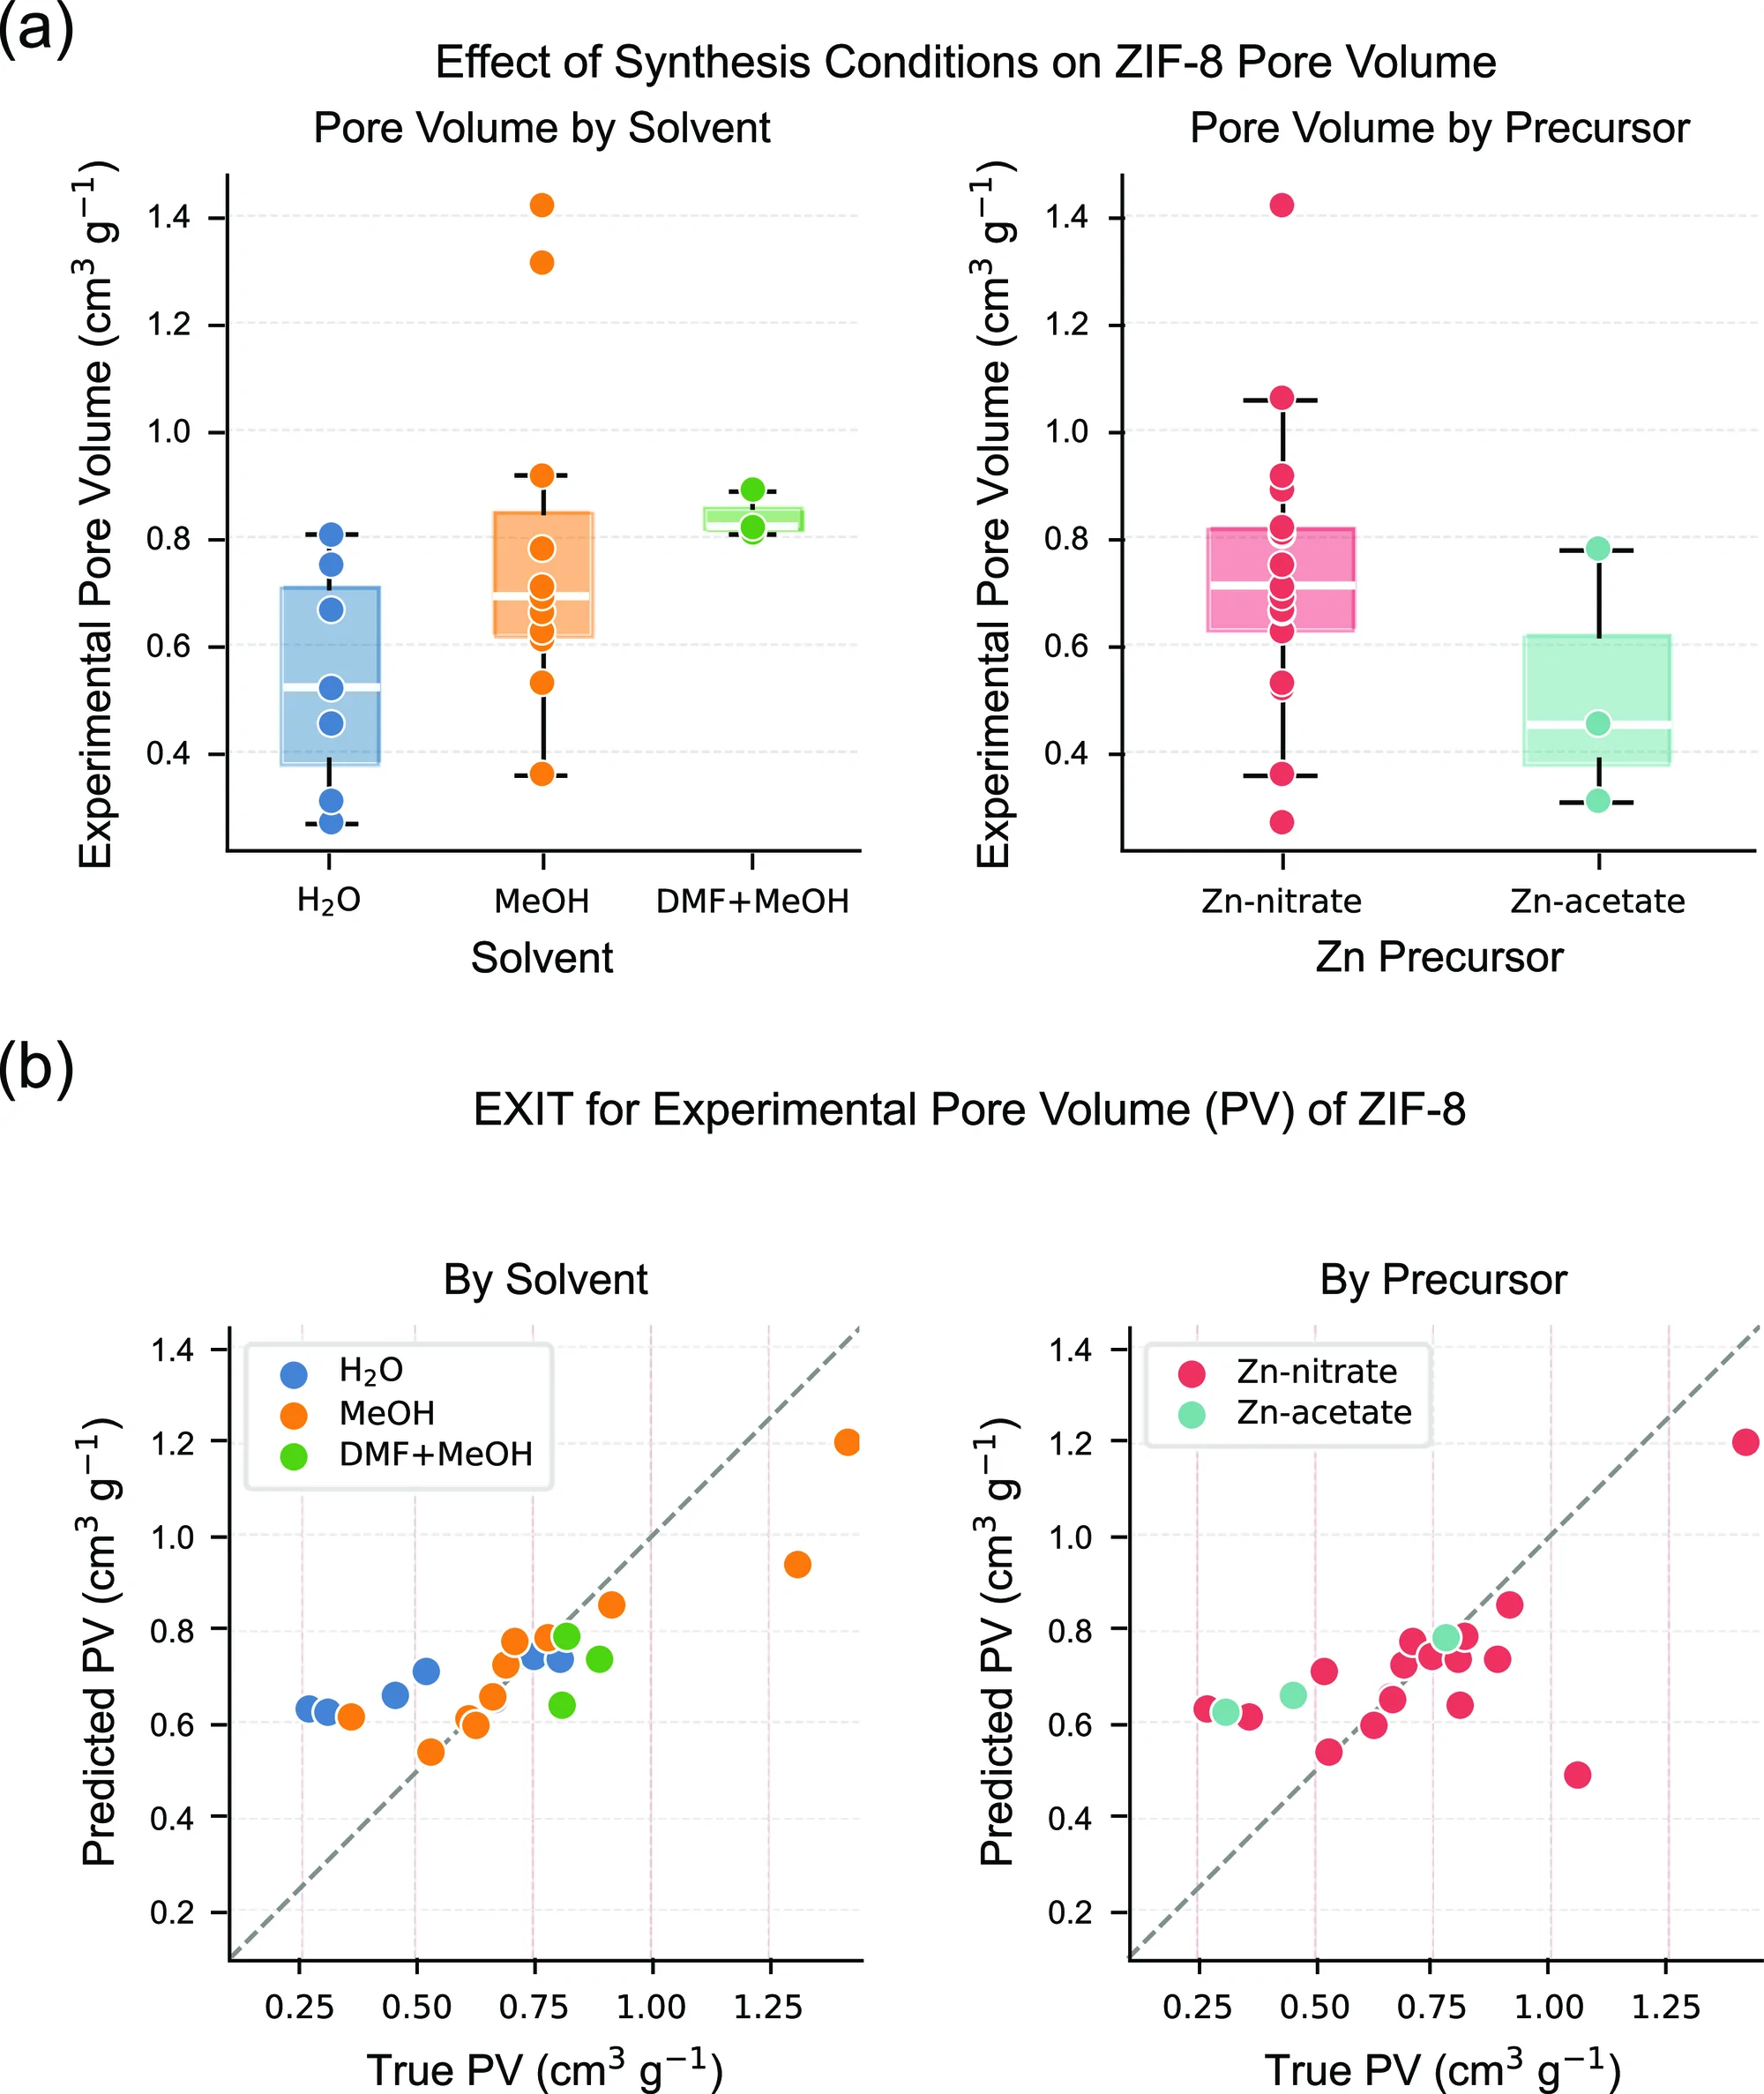
此外,t-SNE 可视化显示,预训练 EXIT 的注意力表示能够捕捉模拟 XRD 与实验 XRD 之间的更广泛区别;而对 ZIF-8 等样品的分析也展示了前驱体和溶剂等合成条件对孔体积的影响,以及 MOF-5 等体系中 Scherrer 晶畴尺寸与预测行为的关系。
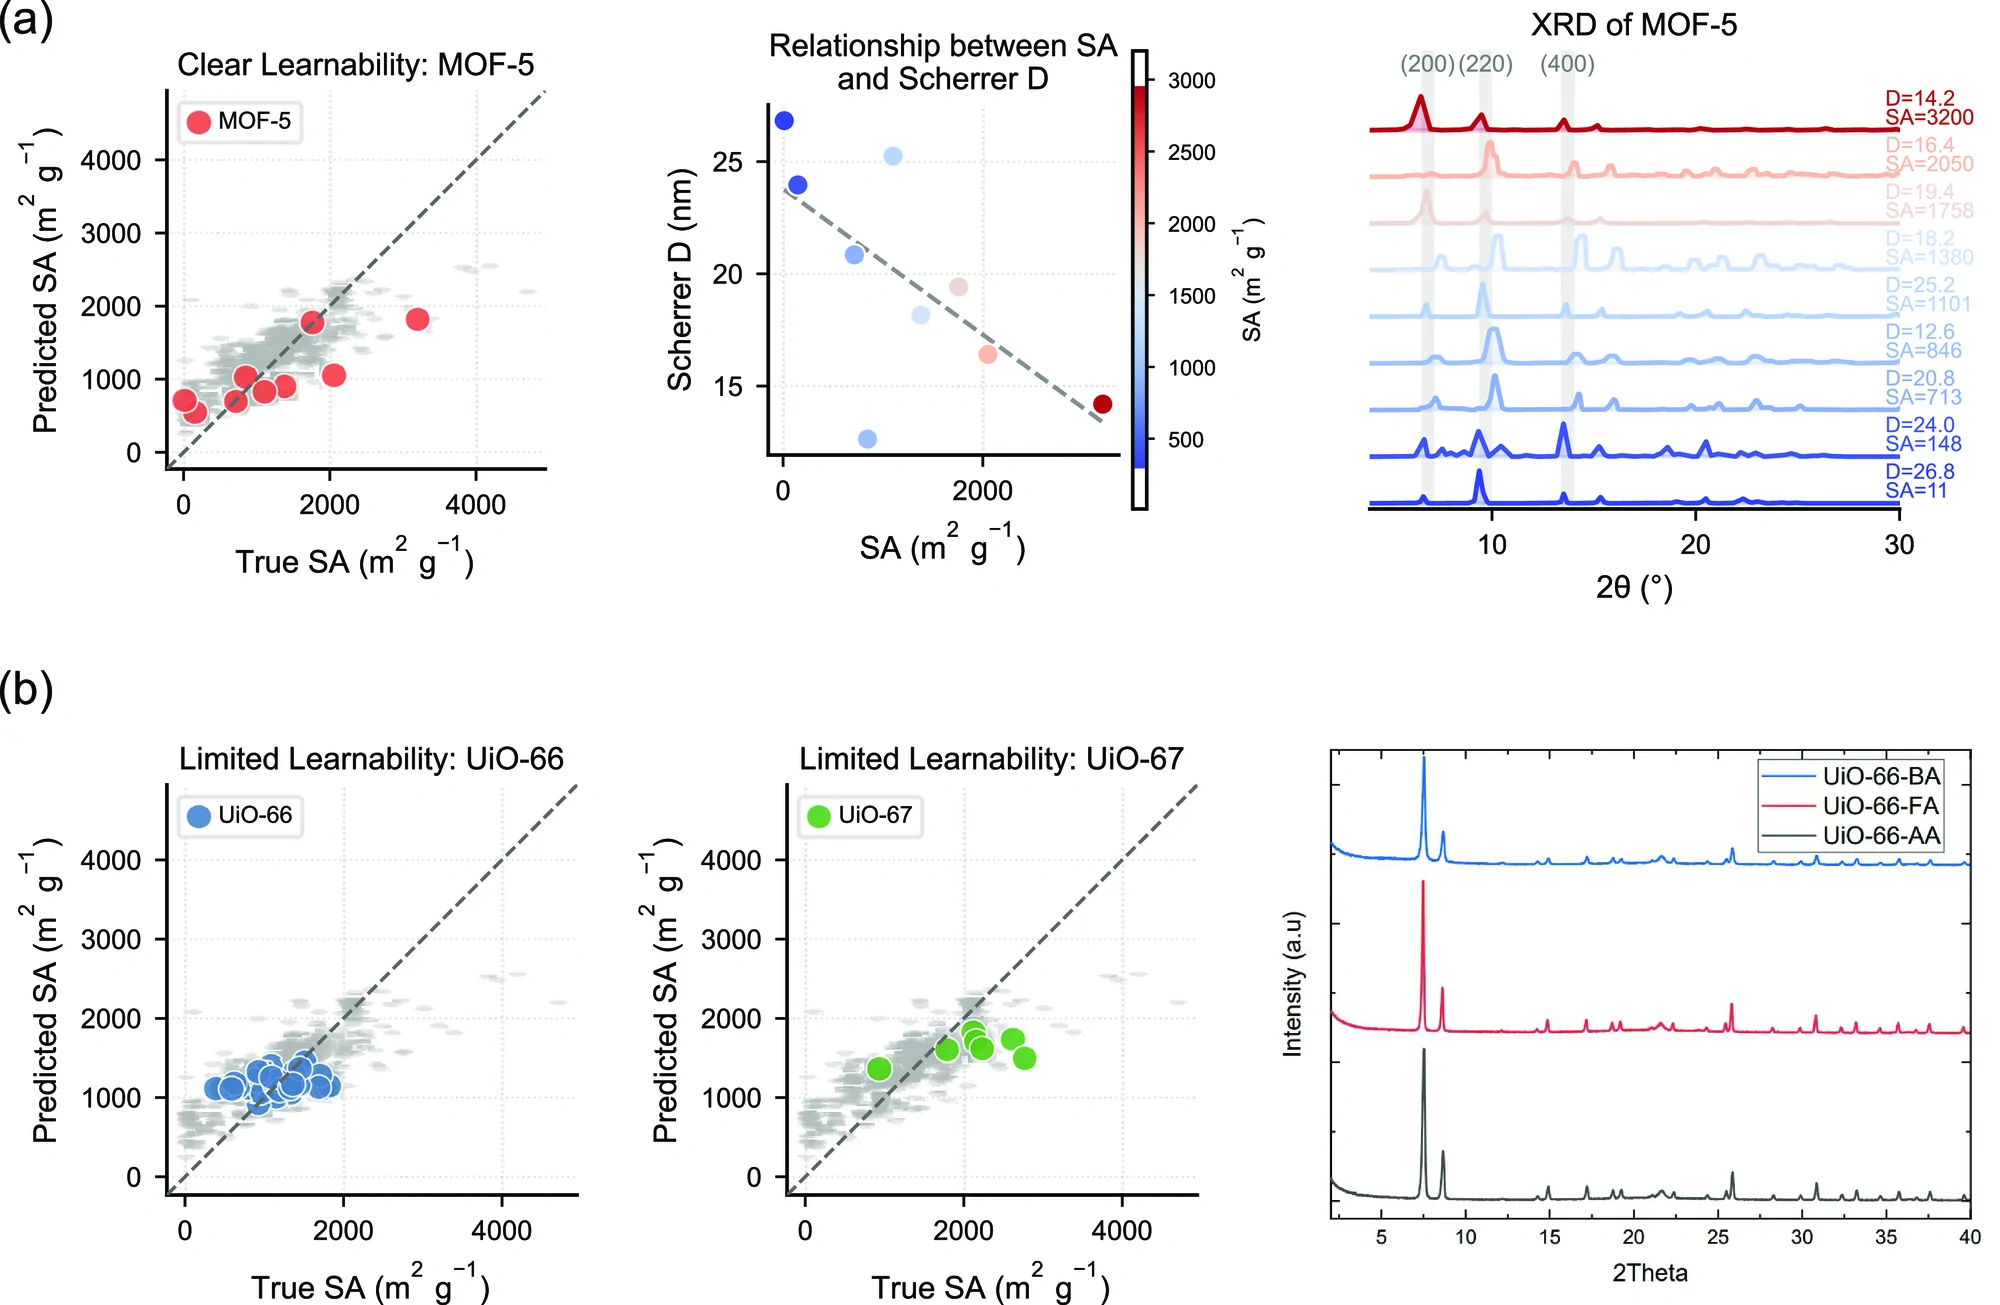
应用意义:让常规表征数据产生预测价值
这项工作的重要意义在于,它把 MOF 性质预测从“框架感知”推进到“样品感知”。粉末 XRD 是 MOF 合成后几乎必做的常规表征,而比表面积和孔体积通常需要额外的气体吸附实验才能测定。EXIT 表明,只要把常规 XRD 图谱纳入模型,就能显著改善对实验样品性质的预测。
这对生物医学相关研究尤其有价值。MOFs 作为潜在药物载体或气体吸附/分离材料时,其吸附性能往往与 BET 比表面积和孔体积直接相关;例如 H2 吸附量常与 BET 表面积经验相关(Chahine 规则)。因此,即使是同一种 MOF,不同样品的实际气体吸附或分离行为也可能不同。XRD 驱动的预测可以帮助研究者优先判断哪些合成样品值得进一步表征或应用测试,从而节省实验成本。
当然,作者强调衍射并不能完全解析实验变异的全部复杂性,但这项工作证明:在 MOF 身份之外,实验 XRD 提供了有用的样品层面信息。EXIT 为多孔材料信息学指明了一个实用方向——把实验表征纳入机器学习输入,是缩小理想化材料表示与真实实验行为之间差距的重要一步。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。