原文:Deciphering transcriptome complexity via long-read sequencing. PubMed | PMC 全文(含 PDF)
转录组学正在经历一场深刻的范式转变:过去十多年里,研究者主要依赖短读长 RNA 测序(short-read RNA-seq)在“基因水平”上定量表达量;而如今,越来越多证据表明,真正决定细胞身份、疾病机制和表型多样性的,往往是“转录本水平”的细节——比如一个基因到底产生了哪一种剪接 isoform、从哪里起始转录、在哪里加尾,以及是否形成了融合转录本。
近日,一篇发表于 iMeta (影响因子 44.4)的综述文章 Deciphering transcriptome complexity via long-read sequencing 系统梳理了这一转型背后的技术逻辑、实验方案与数据分析路径。文章指出,短读长测序虽然在基因表达定量上依然稳健、可扩展,但它把 RNA 分子打断成片段后再测序,面对共享外显子、组合式剪接、重复区域来源转录本时,往往只能依靠统计推断去“拼装”全长转录本,存在天然盲区。
研究背景:为什么“看全长”变得至关重要
在癌症中,致病效应可能并不来自某个基因总表达量的变化,而是来自特定的剪接变体或异常融合基因;在脑和免疫系统等复杂体系中,不同细胞类型与细胞状态之间的差别,常常比基因水平信号更精确地体现在 isoform 使用方式上。
可变剪接(alternative splicing)、可变转录起始位点(ATSS)、可变多聚腺苷酸化(APA)、基因融合、转座元件(TE)相关转录、等位基因特异性表达(ASE)等事件,构成了调控变异与表型多样性之间最直接的桥梁。然而,这些特征中的一部分,用短读长数据不仅“难推断”,甚至从根本上无法直接观测——例如 RNA 修饰、重复元件来源转录本、复杂融合结构,以及同一分子上的多组学关联信息。
长读长测序(long-read sequencing, LRS)的出现,正是为了跨越这一鸿沟。Pacific Biosciences(PacBio)和 Oxford Nanopore Technologies(ONT)等平台能够产生跨越数千碱基甚至覆盖完整 RNA 分子的读段,使研究者可以在单分子层面直接观察外显子连接关系、转录本边界和复杂结构,从而大幅降低短读长分析中的模糊性。
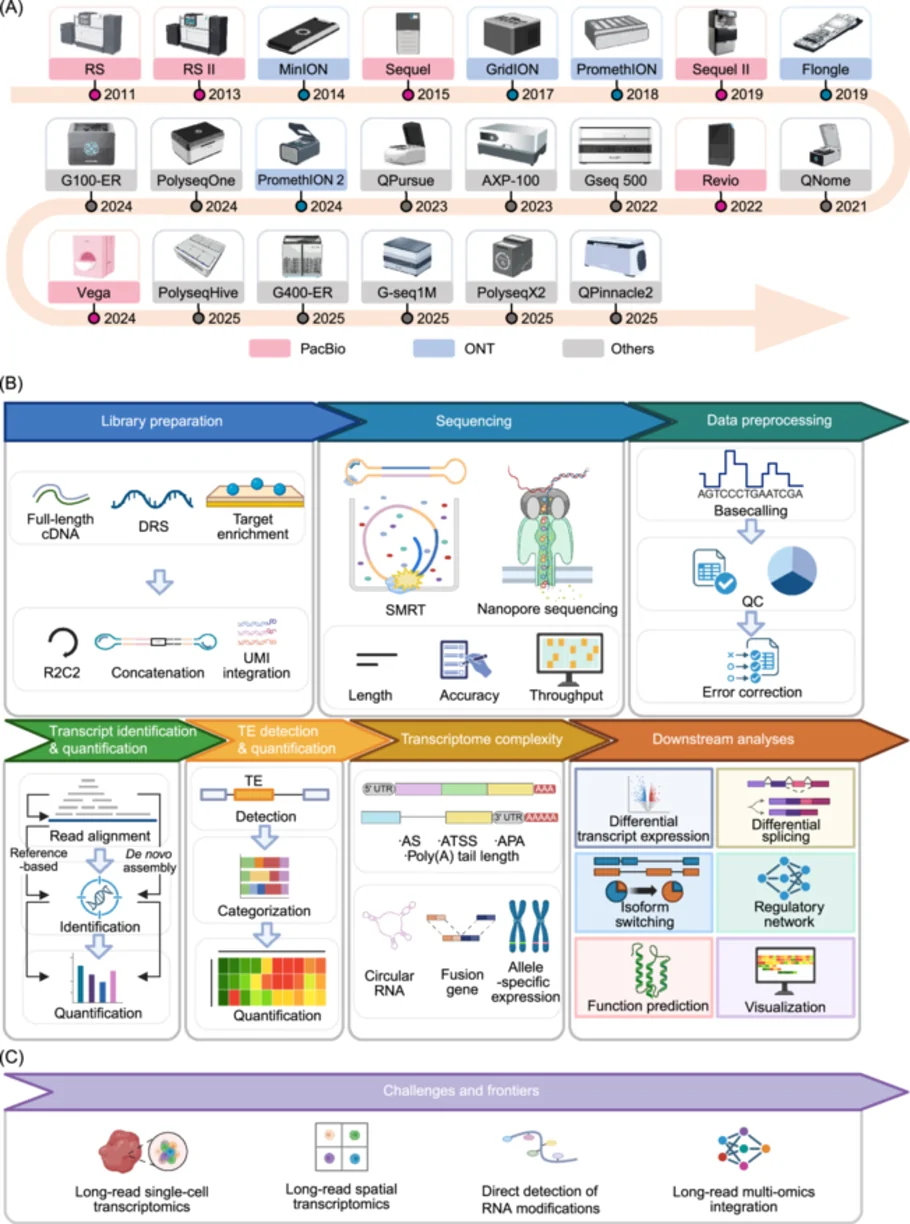
FIGURE 1 FIGURE 1: 长读长转录组学工作流程的全景概览。(A) 来自 PacBio(粉色)、ONT(蓝色)及其他(灰色)的 LRS 平台发展时间线。(B) 基于 LRS 的转录组学研究的端到端工作流程概览。(C) 长读长转录组学向单细胞、空间、直接 RNA 测序及多组学整合应用的前沿。AS,可变剪接;ATSS,可变转录起始位点;APA,可变多聚腺苷酸化;PacBio,Pacific Biosciences;cDNA,互补 DNA;DRS,直接 RNA 测序;ONT,Oxford Nanopore Technologies;R2C2,Rolling Circle to Concatemeric Consensus;UMI,唯一分子标识符;SMRT,单分子实时;QC,质量控制;TE,转座元件;UTR,非翻译区。创建于 BioRender。Li, J. (2026) https://BioRender.com/a3awsvn。核心发现:从平台到分析,给出端到端路线图
这篇综述并不是报告一项新实验数据,而是做了一件对领域极为关键的事:把目前快速演进、却缺乏统一标准的长读长转录组研究,整理成一份“从实验设计到结果解释”的实用路线图。
文章覆盖的范围包括:关键测序技术、研究设计、文库制备、数据处理、转录本识别、定量、下游分析,以及当前挑战与未来方向。作者强调,长读长转录组虽然潜力巨大,但技术门槛并不低——不同平台、不同文库策略会引入不同偏差;而长读长数据本身在信号结构、错误谱上也与短读长完全不同,需要专门的计算流程。
综述特别指出,目前领域仍缺少能系统指导研究者走完“湿实验 + 干实验”全流程的资源。该文通过整合已有工具、基准研究和最佳实践,试图填补这一空白,让更多实验室能以标准化、可重复的方式开展 isoform 水平发现。
方法亮点:PacBio、ONT 与新兴纳米孔平台
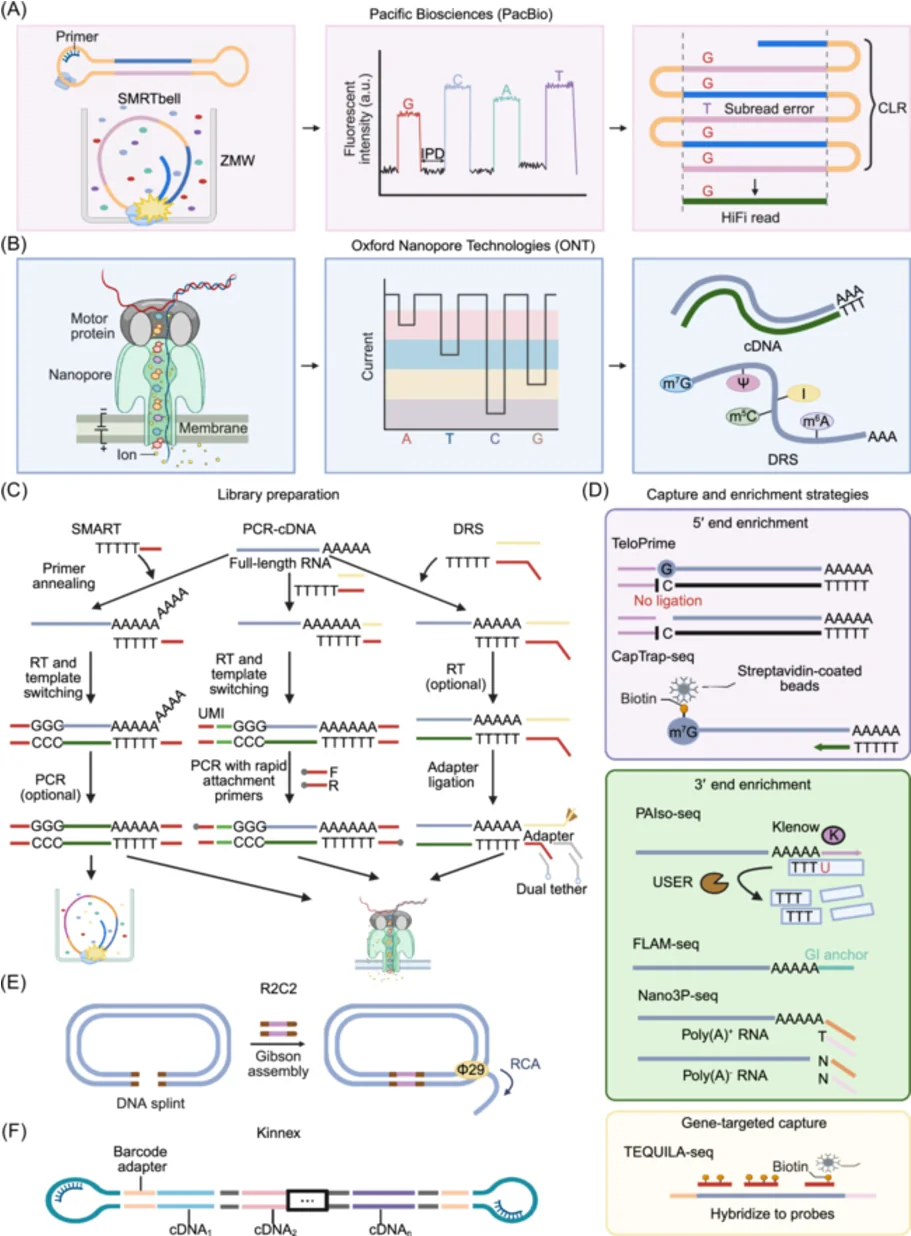
在技术层面,文章首先回顾了两大主流平台。PacBio 的单分子实时(SMRT)测序采用边合成边测序原理:在纳米级零模波导孔(ZMW)中,聚合酶驱动合成反应;其 SMRTbell 文库是环状 DNA 模板,使同一插入片段可被多次读取,从而提高一致性准确度。荧光信号与脉冲间时长(IPD)被同时记录,后者还能提供动力学信息,用于推断 DNA 碱基修饰。
PacBio 提供两种核心模式:连续长读长(CLR)读长超长但错误率较高;而高保真(HiFi)读段通过环形一致性测序(CCS)获得高准确度。其旗舰方案 Iso-Seq 正是基于 HiFi 模式,把反转录得到的全长 cDNA 转化为 SMRTbell 文库,经多轮 CCS 得到高精度转录本读段。
FIGURE 2 FIGURE 2: LRS 平台与原理概览,以及用于转录组学研究的文库制备和富集策略。(A) 对于 PacBio 测序,将 SMRTbell 环状模板加载到 ZMW 中并由聚合酶测序;记录荧光脉冲和 IPD 信号;多次通过产生多个子读段以生成一致性 HiFi 读段。(B) 对于 ONT 测序,马达蛋白控制链通过纳米孔易位;孔产生由局部序列背景决定的离子电流“squiggle”;该 squiggle 经碱基识别转换为序列,而在进行 DRS 时 RNA 碱基修饰可保留在原始信号中。(C) 长读长 RNA-seq 文库制备的三种主要工作流程:SMART、ONT 的 PCR-cDNA 和 DRS。(D) 代表性的捕获和富集策略:5' 端富集(例如 CapTrap-seq)、3' 端富集方法(例如 PAIso-seq)和基因靶向捕获(TEQUILA-seq)。(E) R2C2:滚环扩增产生重复单元,经测序并组装成更高准确性的共有序列。(F) Kinnex:将多个 cDNA 片段串联成单个长模板以提高测序通量。cDNA,互补 DNA;CLR,连续长读段;DRS,直接 RNA 测序;FLAM-seq,全长 mRNA 测序;IPD,脉冲间时长;ONT,Oxford Nanopore Technologies;PacBio,Pacific Biosciences;PAIso-seq,含 poly(A) 的 RNA 异构体测序;PCR,聚合酶链式反应;RT,逆转录;SMRT,单分子实时;SMART,RNA 模板 5' 端的转换机制;R2C2,滚环至串联体共有序列;RCA,滚环扩增;UMI,唯一分子标识符;ZMW,零模波导。创建于 BioRender。Li, J. (2026) https://BioRender.com/bjr2lnu。ONT 则通过监测单链 DNA 或 RNA 分子穿过纳米孔时的离子电流变化来测序。孔蛋白感知电流,马达蛋白控制易位速度;原始“squiggle”信号由 Guppy、Dorado、Bonito 等基于深度学习的 basecaller 转成碱基序列。在转录组应用中,ONT 有 cDNA 测序和直接 RNA 测序(DRS)两种策略:DRS 能保留天然 RNA 分子并直接检测 m6A 等 RNA 修饰,但对 RNA 量、通量和降解更敏感;PCR-cDNA 测序因灵敏度高、兼容低起始量样本,成为社区主流。
除了 PacBio 和 ONT,综述还提到 QitanTech、Polyseq、CycloneSEQ、Axbio、Geneus 等新兴纳米孔平台,以及 Roche 的 SBX、Element Biosciences 的 LoopSeq 等差异化方案。这些系统拓宽了仪器选择、提升了可及性,但许多性能指标仍主要来自厂商和早期研究,尚需独立评估。
文库制备:决定“全长捕获”的关键一步
文章强调,平台只是基础,文库制备才是直接决定全长转录本捕获完整性与效率的核心环节。总体目标是忠实保留 RNA 分子从 5′ 帽到 3′ poly(A) 尾的结构完整性。
目前最广泛使用的是基于 SMART(switching mechanism at the 5′ end of RNA template)原理的全长 cDNA 制备:从 3′ poly(A) 尾引发反转录,到达 5′ 帽时,逆转录酶通过末端转移酶活性添加非模板 dC,带 dG 的模板转换寡核苷酸(TSO)退火后继续合成。由于模板转换只在真实 5′ 端高效发生,提前终止的 cDNA 会被选择性排除,从而天然富集全长克隆。
PacBio Iso-Seq 采用 SMART 生成全长 cDNA,再转化为哑铃状 SMRTbell 文库;ONT 的 PCR-cDNA 流程则包括反转录与链转换、PCR 扩增、测序接头连接三步,其中 RT 接头退火到 poly(A) 尾末端,还能用于估算 poly(A) 长度。
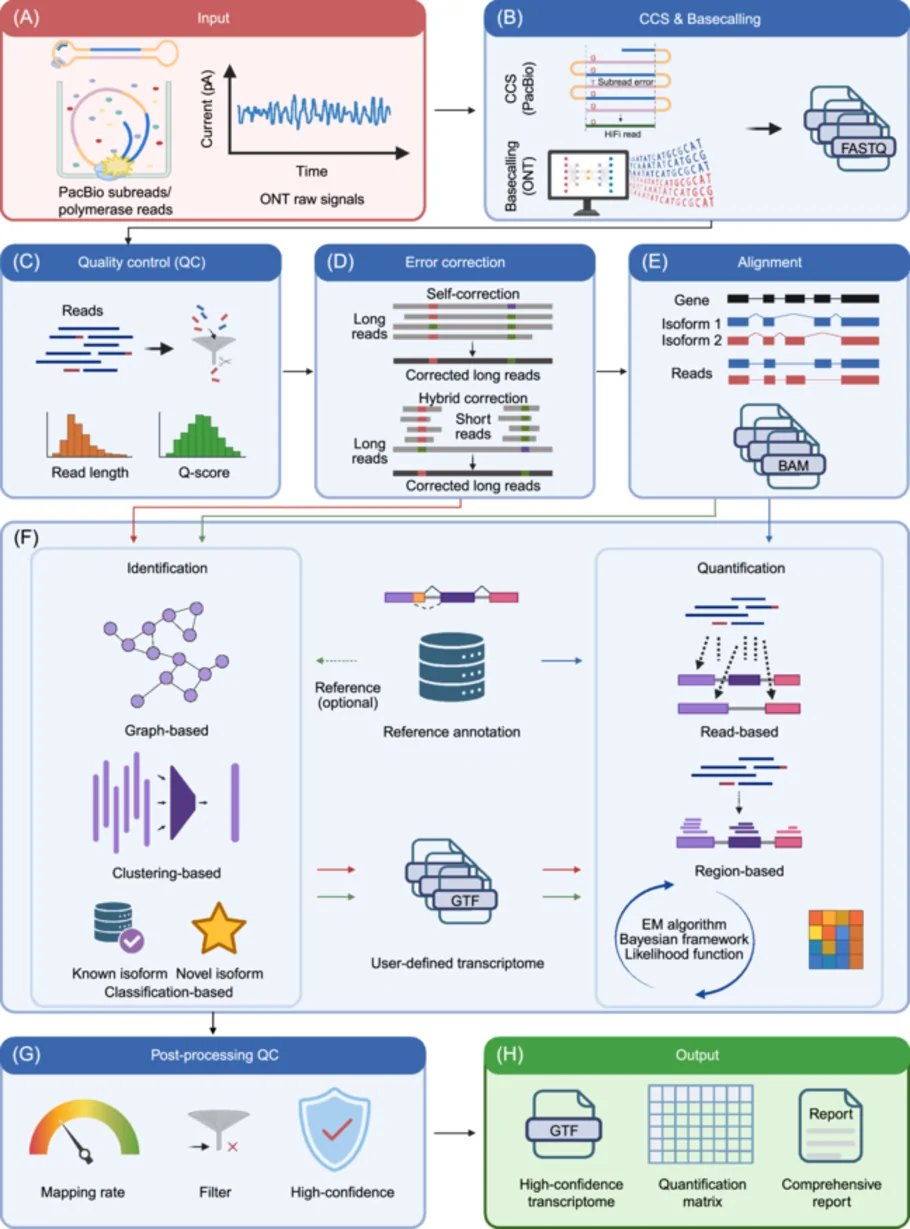
FIGURE 3 FIGURE 3: 长读长转录组数据分析的计算工作流程。(A) PacBio 子读段/聚合酶读段和 ONT 原始电流信号是平台特异性预处理的输入数据。(B) PacBio 子读段/聚合酶读段经处理生成 CCS,其结合同一分子的重复观测以减少子读段错误并生成高准确性 HiFi 读段。ONT 原始信号通过碱基识别转换为核苷酸序列。所得的 PacBio 和 ONT 读段随后转换为 FASTQ 格式以进行 QC。(C) QC 根据质量相关指标(如读段长度和 Q 值)过滤读段,以在下游分析前去除低质量序列/碱基。(D) 纠错通过使用重叠读段的自我校正或整合短读段数据的混合校正来提高长读段准确性。(E) 比对将高质量读段映射到参考序列(通常是参考基因组),以生成比对文件(BAM)并解析外显子-内含子结构和异构体特异性读段映射。(F) 转录本识别和定量可通过三种不同策略执行,如彩色箭头所示。红色路径代表无参考推断策略,直接使用质控后的读段进行从头转录本重建和定量,无需参考基因组比对,特别适用于缺乏参考基因组的物种。绿色路径说明基于参考的推断方法,其中利用比对后的读段通过基于图、基于聚类或基于分类的方法推断转录本模型。该策略区分已知和新型异构体,生成用户定义的转录组(GTF)用于后续定量。蓝色路径描绘注释驱动的方法,其绕过新转录本识别步骤并直接基于现有参考注释定量表达;这提供了计算上更高效的途径,但排除了新异构体的发现。在识别过程中,可选用参考注释来指导转录本模型构建。定量依赖于基于读段或基于区域的策略,并通常使用概率框架,如 EM 算法、贝叶斯模型或基于似然的推断,以生成表达估计。(G) 后 QC 使用诸如比对率、比对质量阈值(MAPQ)和置信度过滤等指标评估比对和定量结果,以保留高置信度的转录本模型和表达估计。(H) 最终输出包括高置信度转录组注释(GTF)、转录本/异构体定量矩阵和综合分析报告。CCS,环状一致性测序;QC,质量控制;EM,期望最大化;pA,皮安;Q score,Phred 质量值。创建于 BioRender。Li, J. (2026) https://BioRender.com/no4nlqs。下游分析:从转录本识别到重复区域与复杂事件
在计算分析方面,综述给出了长读长转录组数据的处理框架:PacBio 的 subreads/polymerase reads 与 ONT 的原始电流信号分别进入平台特异性预处理,随后进行质量控制、纠错、比对、转录本重建、注释和定量。
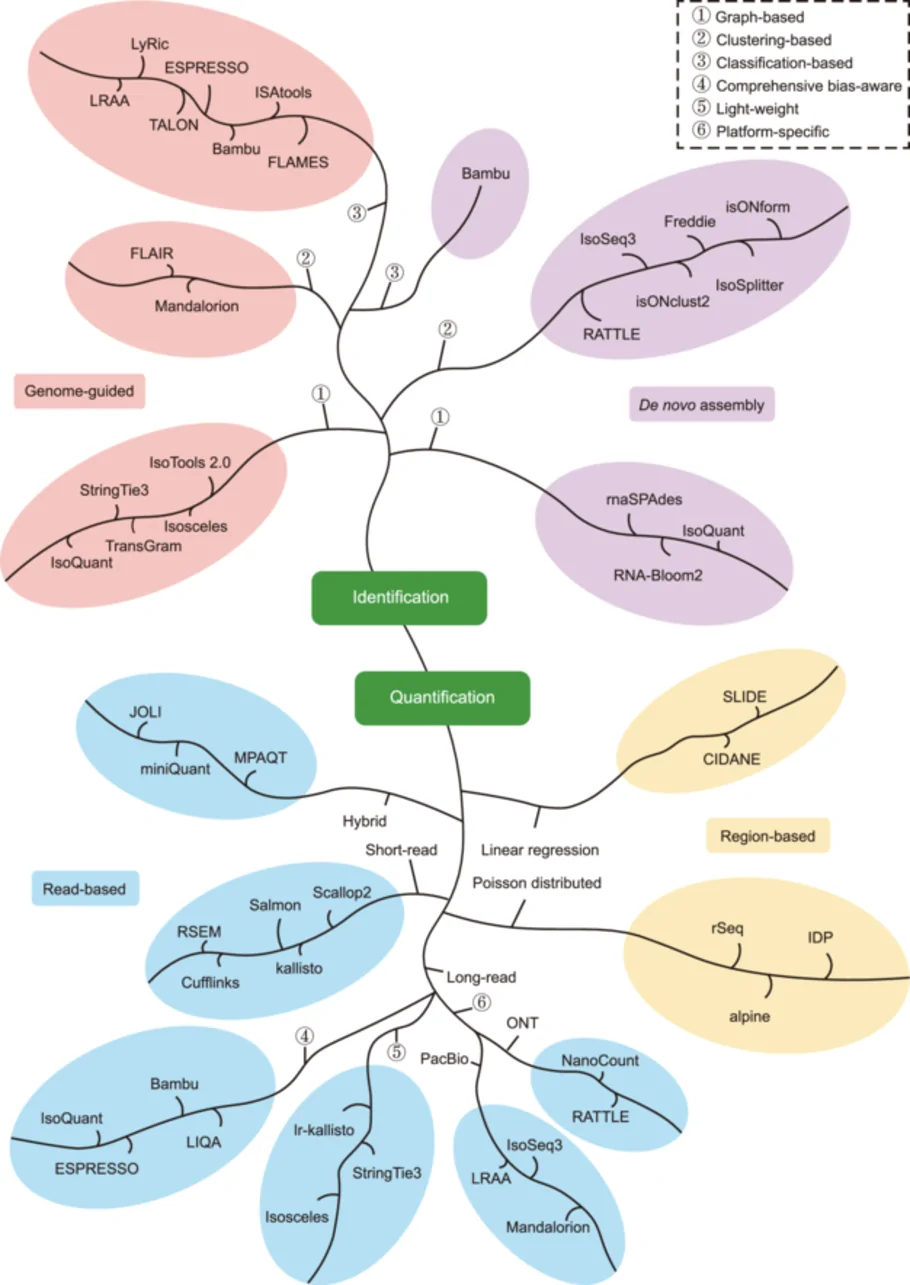
FIGURE 4 FIGURE 4: 用于转录本识别和定量的计算工具的方法学系统发育。此图根据方法学相似性组织用于基于 LRS 的转录本识别和定量的代表性软件。上半部分总结异构体识别策略,包括基因组引导和从头组装方法。识别方法进一步按核心算法范式分组:(1) 基于图、(2) 基于聚类和 (3) 基于分类的框架(分支上的数字)。下半部分总结异构体/转录本定量方法,区分基于读段和基于区域的模型,并突出不同的数据体系(短读段、混合和长读段)。长读段定量方法进一步分类为 (4) 综合偏差感知、(5) 轻量级和 (6) 平台特异性方法。诸如泊松分布和线性回归等标签表示部分工具使用的典型统计假设。工具名称置于每个模块内,以说明每个方法学类别下的代表性实现。ONT,Oxford Nanopore Technologies;PacBio,Pacific Biosciences。文章用多张示意图说明了长读长相较短读长的优势:在转座元件来源转录本分析中,长读长能区分不同 TE 家族结构并改进定量;在复杂转录事件中,长读长可识别不同的 5′ 和 3′ 转录本末端,并准确判断一条读段来自哪一种 isoform。
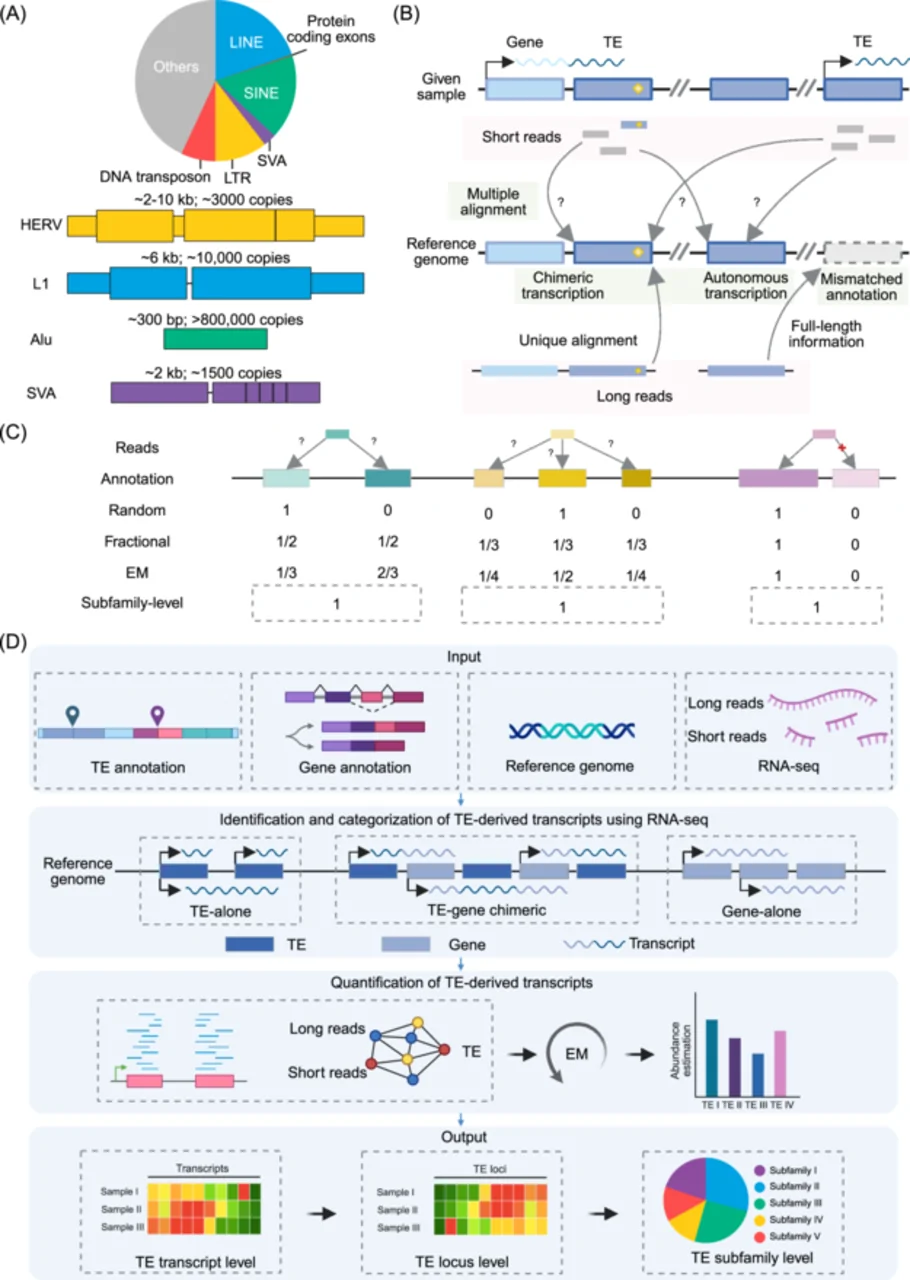
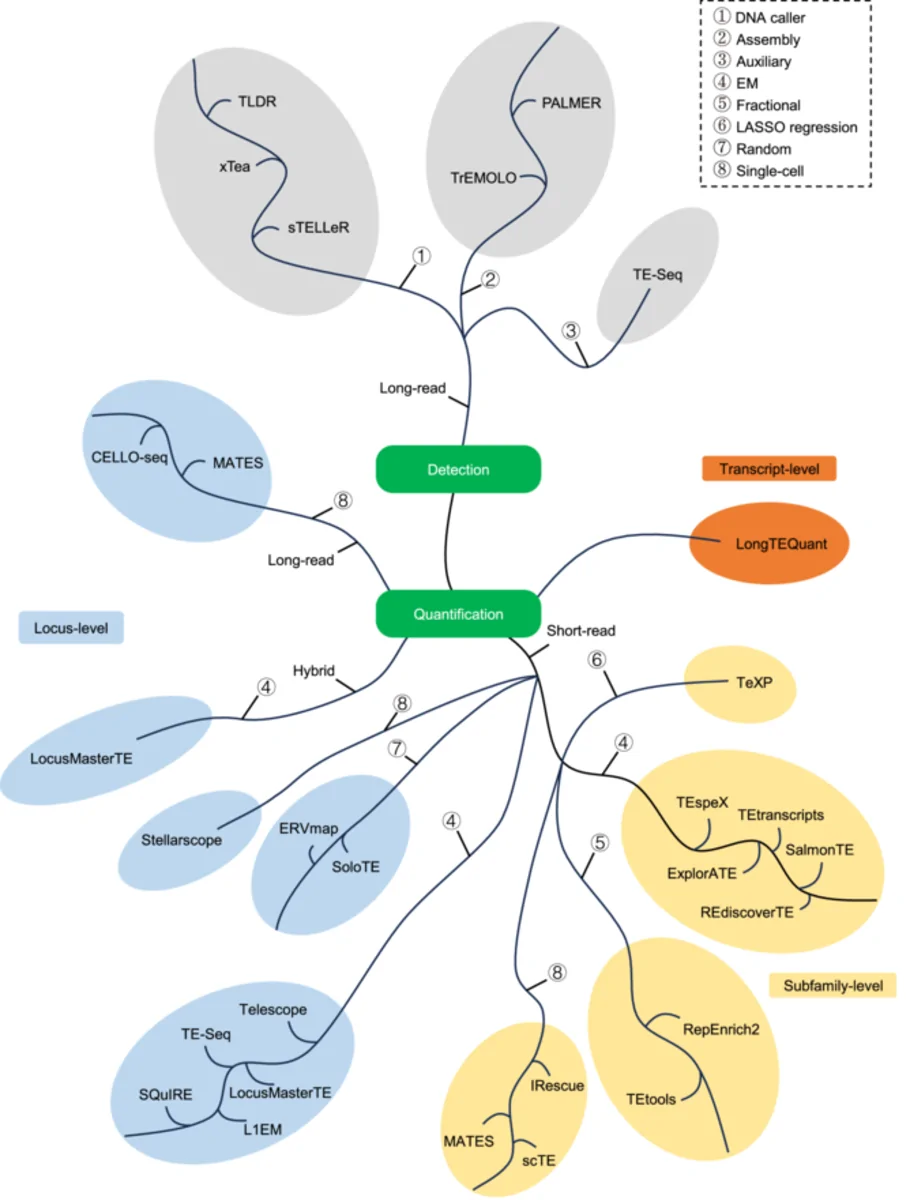
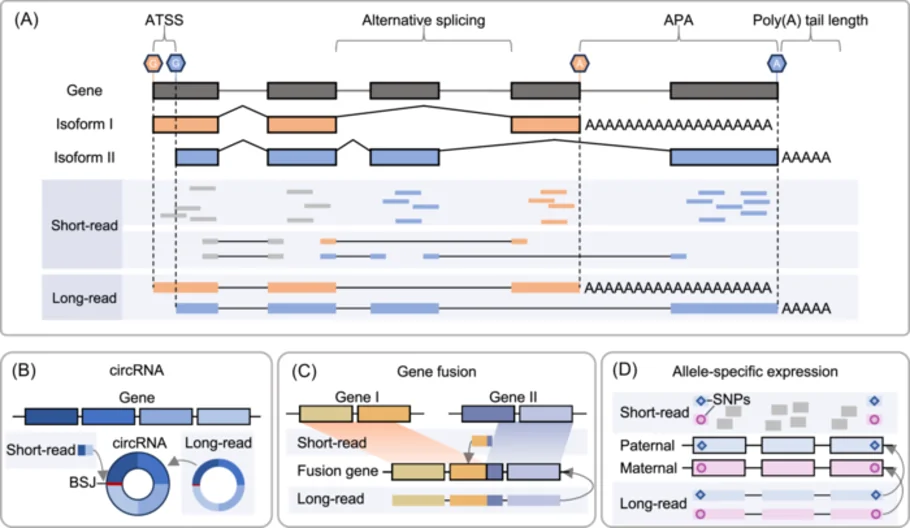
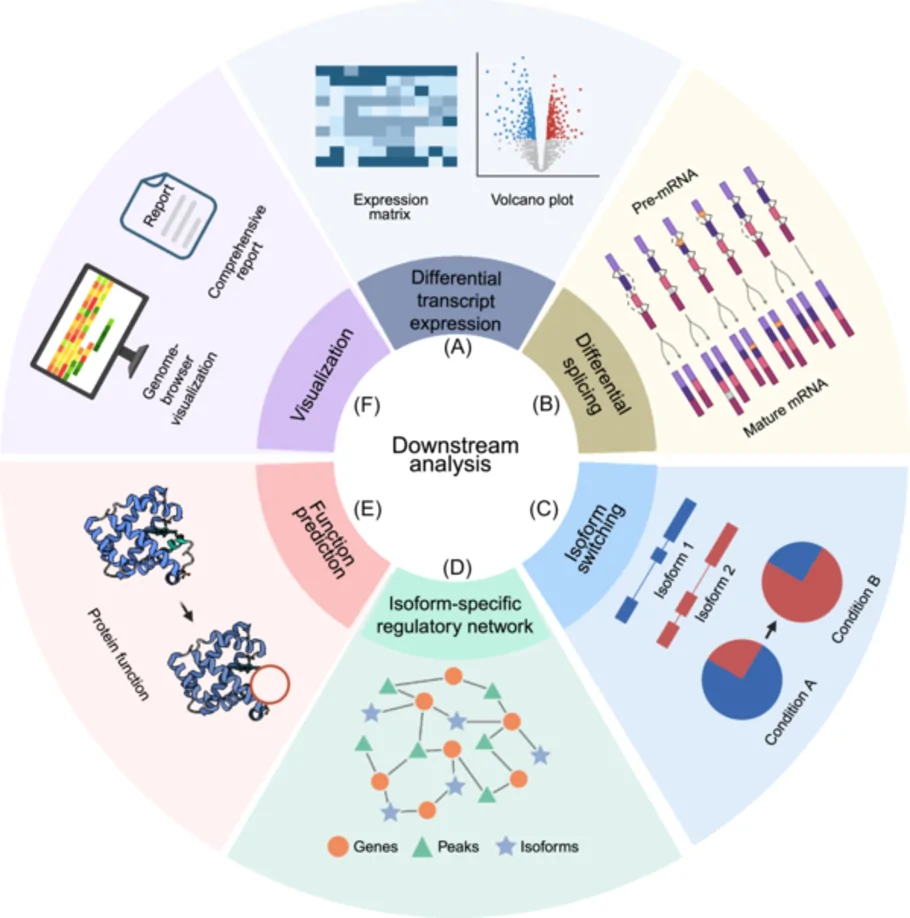
FIGURE 5 FIGURE 5: 转座元件衍生转录本的特征分析。(A) TE 的分类。图示了主要 TE 家族的代表性结构特征。(B) 长读段相对于短读段在 TE 转录本分析中的优势。由于 TE 的重复性质,短读段常映射到多个基因组位置,导致比对模糊且难以区分自主 TE 转录和基因-TE 嵌合转录本。相比之下,长读段可跨越转录本的较大部分,实现唯一比对并提高 TE 衍生转录事件的分辨率。(C) 基于 RepeatMasker 注释的传统 TE 定量策略示意图。常规 TE 定量方法依赖 RepeatMasker TE 注释,并使用不同算法分配映射到重复 TE 位点的读段。这些方法包括唯一分配、分数分配和基于期望最大化(EM)的概率模型,以在候选 TE 位点或亚家族间分配多重比对读段。(D) 用于转录本水平 TE 定量的 LongTEQuant 流程概览。LongTEQuant 工作流程整合 TE 注释、基因注释、参考基因组和 RNA-seq 数据(长读段或短读段)作为输入。TE 衍生转录本首先在转录本水平被识别并分类为单独 TE 转录本、TE-基因嵌合转录本和仅基因转录本。然后使用长读段、短读段或两类数据执行定量,以估计跨转录本的 TE 表达。最终输出包括在多层次汇总的 TE 表达谱,包括 TE 亚家族、TE 位点和 TE 衍生转录本水平。EM,期望最大化;LTR,长末端重复;LINE,长散在核元件;SINE,短散在核元件;ORF,开放阅读框;RNA-seq,RNA 测序;TE,转座元件;TIR,末端反向重复;UTR,非翻译区。创建于 BioRender。Li, J. (2026) https://BioRender.com/yfm6pj3。FIGURE 6 FIGURE 6: TE 插入检测和 TE 衍生转录本定量的计算格局。此图根据测序数据类型、定量分辨率和核心算法原则组织用于 TE 检测和表达定量的代表性计算策略。检测分支总结基于长读段的方法,分类为 (1) DNA 检出工具、(2) 基于组装的方法和 (3) 辅助方法。定量分支分为三个主要数据体系:短读段、长读段和混合方法。基于短读段的 TE 定量方法进一步按分辨率分组,包括亚家族水平和位点水平方法。方法还根据其核心计算策略分类,如分支上的数字所示:(4) EM、(5) 分数分配、(6) LASSO 回归、(7) 随机分配和 (8) 面向单细胞的方法。基于长读段的方法利用长距离转录本信息以提高比对特异性和 TE 表达推断,而混合方法整合短读段和长读段数据以增强位点水平分辨率和定量准确性。此外,转录本水平框架直接使用转录本解析信息定量 TE 衍生转录本。工具名称置于每个集群内,以说明每个方法学类别下的代表性实现。EM,期望最大化;LASSO,最小绝对收缩和选择算子;TE,转座元件。FIGURE 7 FIGURE 7: 长读段相对于短读段在解析复杂转录事件中的优势。(A) 长读段可识别不同的 5' 和 3' 转录本末端并准确确定读段源自哪个异构体,而短读段常难以精确比对。长读段测序还能以高置信度解析复杂可变剪接事件,而短读段常因许多读段(灰色)源自多个异构体共享的区域而遭受模糊比对,仅异构体特异性读段(蓝色和橙色)可被唯一分配。此外,长读段可直接测量 poly(A) 尾的长度,而短读段通常无法可靠确定长 poly(A) 尾长度。(B) 与短读段相比,长读段对全长环状 RNA 结构提供更强的全局分辨率。(C) 长读段可直接捕获融合转录本的全长结构,而短读段通常仅提供部分或局部信息。(D) 长读段可通过连接多个 SNP 准确确定全长转录本源自父本还是母本等位基因,而短读段仅能为包含信息性 SNP 的有限读段子集分配亲本来源。ATSS,可变转录起始位点;APA,可变多聚腺苷酸化;BSJ,反向剪接连接点;circRNA,环状 RNA;SNP,单核苷酸多态性。下游分析还包括差异转录本表达、可变剪接、融合转录本、ASE、环状 RNA、RNA 修饰和重复来源转录等。作者汇总了代表性软件的方法学谱系,帮助研究者根据数据类型选择合适的工具。
FIGURE 8 FIGURE 8: LRS 支持的转录组学研究的下游分析。(A) 差异转录本表达分析生成表达矩阵并识别条件间显著变化的异构体。(B) 差异剪接分析以全长视图检测条件相关的可变剪接事件。(C) 异构体转换分析量化同一基因异构体相对使用在条件间的变化。(D) 异构体特异性调控网络推断将转录本异构体与上游调控因子和下游靶标联系起来,以揭示异构体水平的调控程序。(E) 功能预测注释异构体并评估对蛋白质结构域和生物功能的潜在影响。(F) 可视化和报告通过基因组浏览器和综合报告整合结果,以促进解读和传播。创建于 BioRender。Li, J. (2026) https://BioRender.com/14i3g8k。应用意义:走向单细胞、空间与多组学前沿
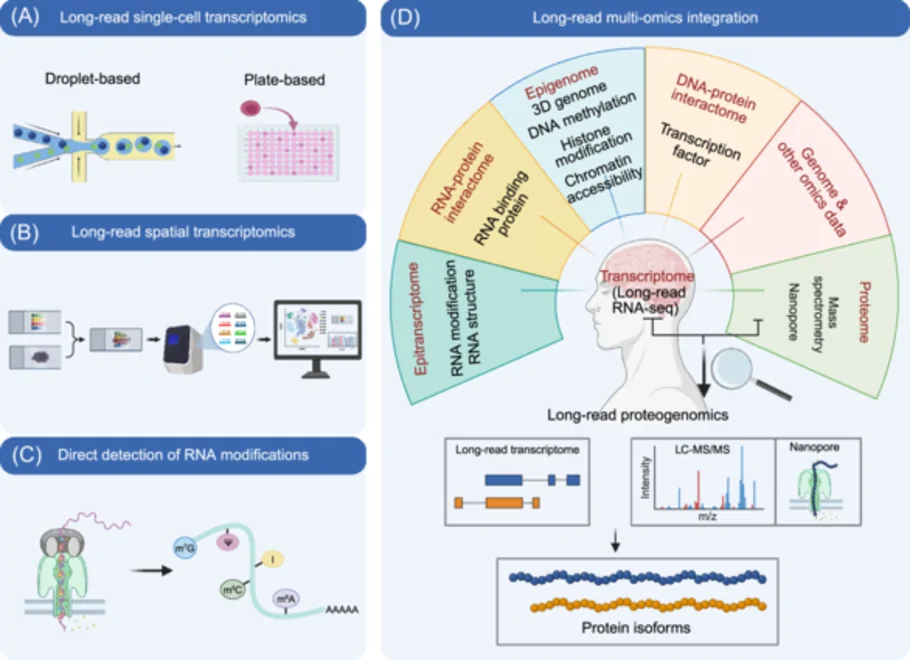
综述最后展望了长读长转录组的新前沿:与单细胞分辨率结合,可在 isoform 水平刻画细胞异质性;与空间转录组、DRS、多组学整合结合,则能在同一分子或同一细胞中把转录本身份与其他分子特征联系起来。
FIGURE 9 FIGURE 9: 长读长转录组学研究的新兴前沿。(A) 长读长单细胞转录组学将 LRS 与单细胞分辨率整合,实现细胞异质性的异构体水平表征。关键技术路线包括基于液滴的高通量方法和基于平板的深度覆盖方法,两者均利用细胞条形码和 UMI 进行准确分子分配。(B) 长读长空间转录组学在捕获全长异构体信息的同时保留空间坐标,使得能够研究组织切片内空间解析的可变剪接和多聚腺苷酸化。(C) 通过直接 RNA 测序直接检测 RNA 修饰保留天然 RNA 分子,并允许在单分子分辨率下同时分析 RNA 序列、多种修饰类型和高级结构特征,无需抗体富集或化学转化。(D) 长读长多组学整合使得从同一样品甚至同一分子同时或协调分析多个分子层成为可能,包括基因组、表观基因组、转录组和表观转录组以及蛋白质组,提供从基因型到表型且具有全长异构体分辨率的统一框架。LC-MS/MS,液相色谱-串联质谱;UMI,唯一分子标识符。创建于 BioRender。Li, J. (2026) https://BioRender.com/8sdfzpb。对生物医学科研读者而言,这篇 iMeta 综述的价值在于:它不只告诉人们“长读长能做什么”,更提供了可复用的框架、决策清单和最佳实践建议。随着读长、准确度、通量和成本持续改善,长读长转录组正从一种专门用于转录本发现的特殊手段,转变为在多种生物学场景中研究转录组复杂性的实用工具。
换言之,当研究问题从“这个基因表达量变了吗”升级为“到底是哪一种转录本、在哪个细胞、以什么结构在起作用”时,长读长测序正在成为回答这些问题的标准配置。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。