文章中心
了解、体验、感悟、分享——汇聚平台使用教程与科研动态。
用血常规预测高危克隆造血:PRISM模型问世
原文:Derivation of a blood count-based machine learning model to prioritise sequencing for high-risk clonal haematopoiesis: a retrospective cohort study.
期刊:EClinicalMedicine(影响因子 12.8) | PubMed | PMC 全文(含 PDF)
研究背景:为什么要在测序前先“筛人”?
随着年龄增长,人体造血干细胞会不断积累体细胞突变。当这些突变发生在与血液肿瘤相关的驱动基因上,并且突变细胞在骨髓或外周血中形成可检测的克隆时,就出现了一种被称为克隆造血(clonal haematopoiesis)的状态。在没有任何恶性肿瘤证据的老年人中,这种克隆扩增并不少见:65岁以上人群里,最多可有约20%能检测到相关突变。
克隆造血本身不是癌症,但它被公认为髓系肿瘤——包括急性髓系白血病(AML)和骨髓增生异常综合征(MDS)——的前驱状态,同时也与心血管疾病等非恶性健康风险相关。临床上常用“意义未明的克隆造血”(CHIP)和“意义未明的克隆性血细胞减少”(CCUS)来描述其中具有前驱意义的两类。
问题在于:绝大多数携带克隆造血的人并不会进展为血癌。研究显示,克隆造血人群每年转化为髓系肿瘤的比例仅约0.5%–1.0%,10年累积风险在不同亚群中差异极大——低危者不足1%,而真正高危者可达约52%。现有的克隆造血风险评分(CHRS)虽然能结合突变基因、变异等位基因频率(VAF)、血细胞参数和年龄来分层,但在人群规模测序中,仅约1%的克隆造血者属于高危。
这意味着,如果对所有成年人都直接做高通量测序来寻找“高危克隆造血”,不仅成本高昂、全球基因组检测资源有限,还会造成大量低危人群的过度诊断。因此,研究者提出一个关键问题:能不能在用昂贵测序之前,先用便宜、常规可得的数据——比如全血细胞计数(CBC)——把最可能携带高危克隆造血的人先挑出来?
核心发现:PRISM模型用血常规给人群分三类
在这项发表于《EClinicalMedicine》(影响因子12.8)的回顾性队列研究中,研究团队开发并验证了一个名为PRISM(pre-sequencing risk model,测序前风险模型)的机器学习模型。PRISM的输入非常“接地气”:只使用血常规参数、年龄和性别,不需要任何测序结果。
研究者首先利用英国生物银行(UK Biobank, UKB)中461,576名合格参与者的数据。他们根据是否进展为髓系肿瘤、以及是否携带具有CHRS高危分子特征的克隆造血,给每个人打上“金标准”标签:阳性为携带高危克隆造血且后续发生髓系肿瘤;阴性为不携带高危特征克隆造血;不确定(equivocal)为有较高危分子特征但尚未记录到髓系肿瘤事件。
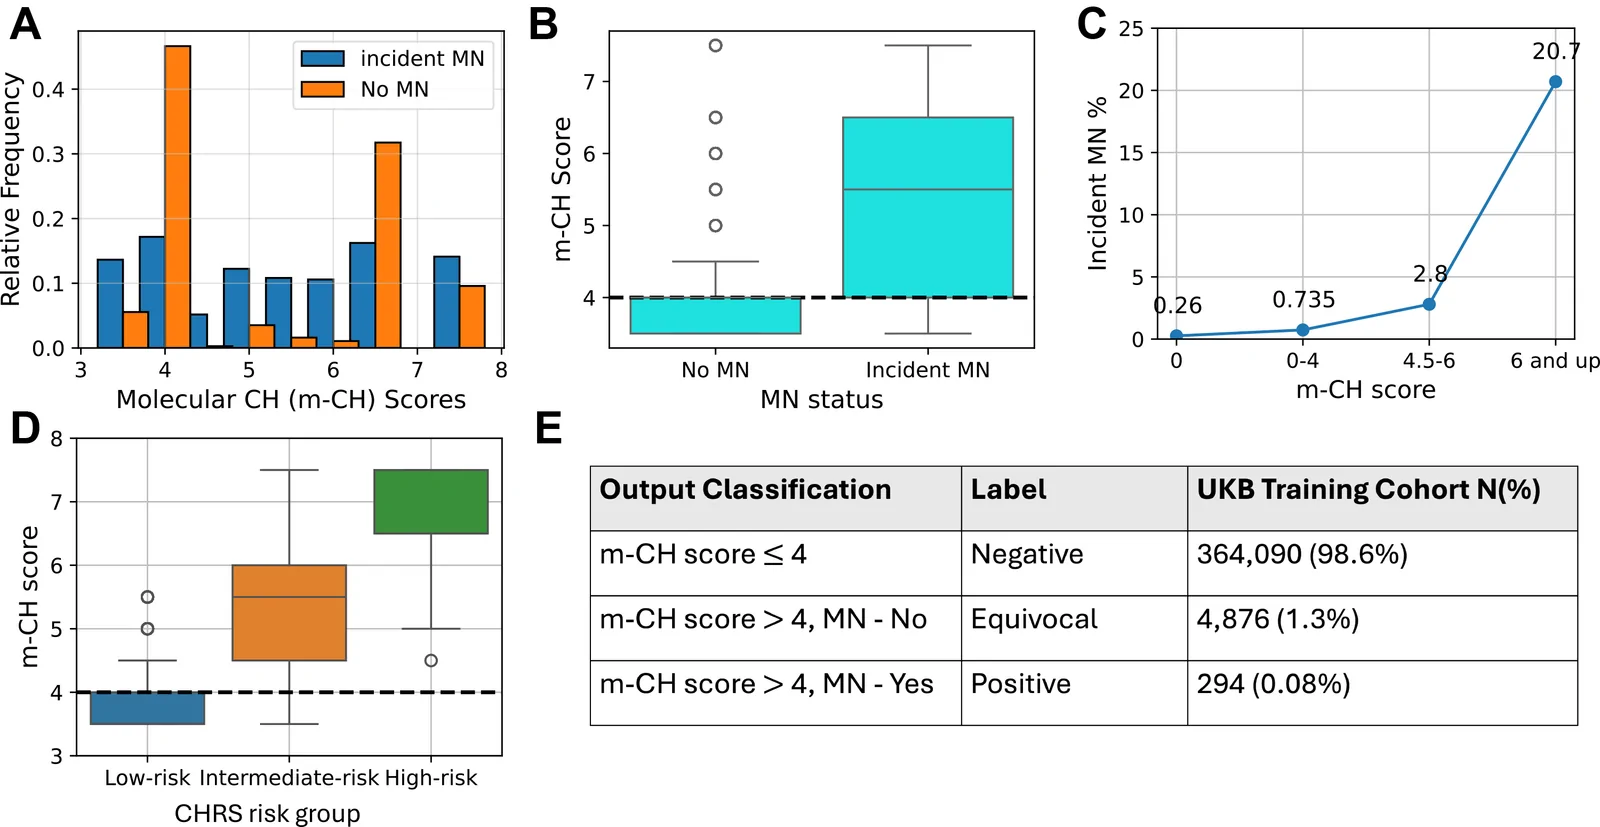
在训练集中,研究者先给每个克隆造血阳性者计算了一个“分子克隆造血评分”(m-CH score),范围0–7.5,由CHRS中的分子预测因子加总而来:是否携带高危基因(如JAK2、SRSF2、SF3B1、TP53、RUNX1、IDH1/2、FLT3等)、是否仅为单一DNMT3A突变、是否携带两个及以上突变、以及最大VAF是否≥20%。图1展示了UKB训练集中,发生与未发生髓系肿瘤的克隆造血个体其m-CH评分的分布差异。
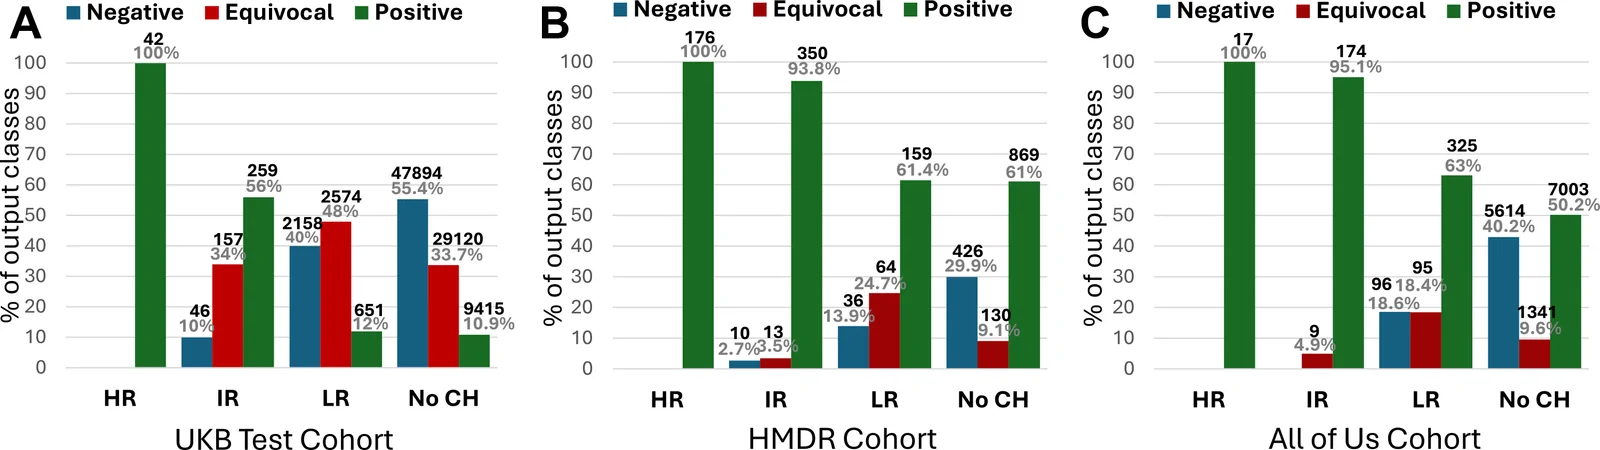
PRISM的输出不是简单的“有/无”,而是把人群分成三类:需要进一步测序的阳性类、可暂缓测序的阴性类、以及仅靠血常规还不足以决策的不确定类。结果显示,PRISM能把所有真正高危克隆造血病例都归为阳性;同时把40%(2158/5383)的低危克隆造血者和55%(47,894/86,429)的克隆造血阴性者判为阴性,从而大幅缩小需要测序的人群。
在性能验证上,PRISM在三个队列中表现稳健:在UKB内部测试集(92,316人)中,曲线下面积(AUC)为0.89(95% CI 0.85–0.93);在丹娜-法伯癌症研究所血液恶性肿瘤数据库(HMDR,2233例临床病例)中为0.74(0.61–0.84);在美国“All of Us”人群数据库(14,674人)中为0.87(0.77–0.96)。更重要的是阴性预测值(NPV)极高:UKB测试集为0.993,HMDR为0.968,All of Us为0.998。也就是说,被PRISM判为“阴性”的人,几乎不可能携带高危克隆造血,测序收益很低。
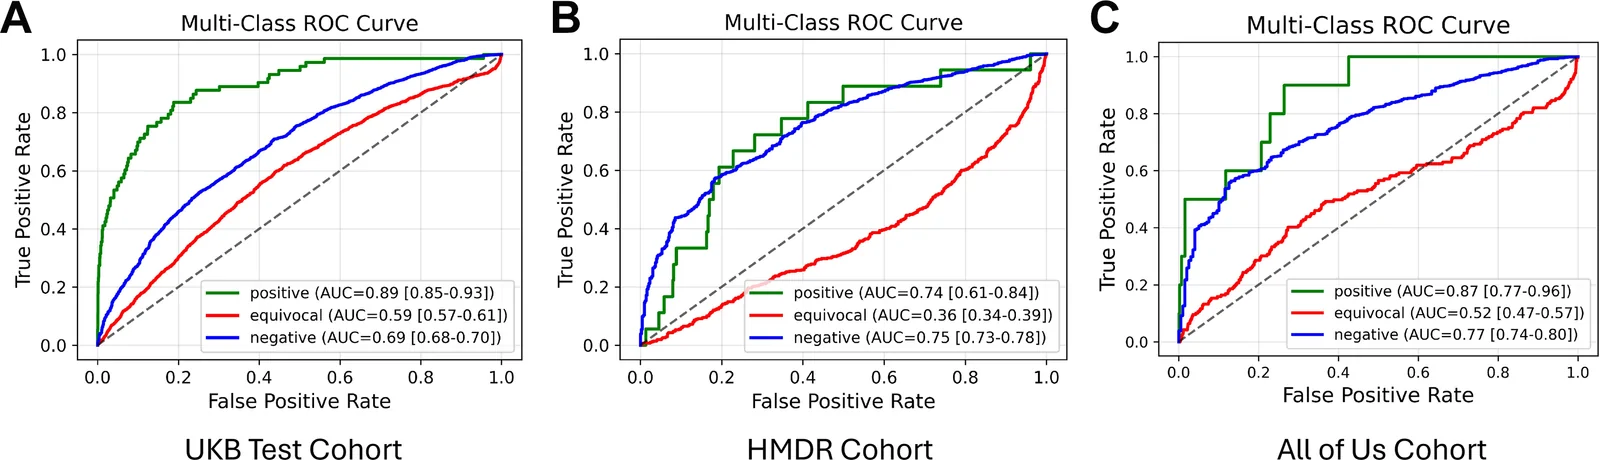
图2进一步展示了PRISM在UKB测试集、HMDR等队列中,对阳性、不确定、阴性三类进行“一对其余”ROC分析的性能曲线。研究者还将PRISM分类与测序后CHRS风险预测进行比较(图3),说明PRISM能在不做测序的情况下,预先逼近分子分层的结果。
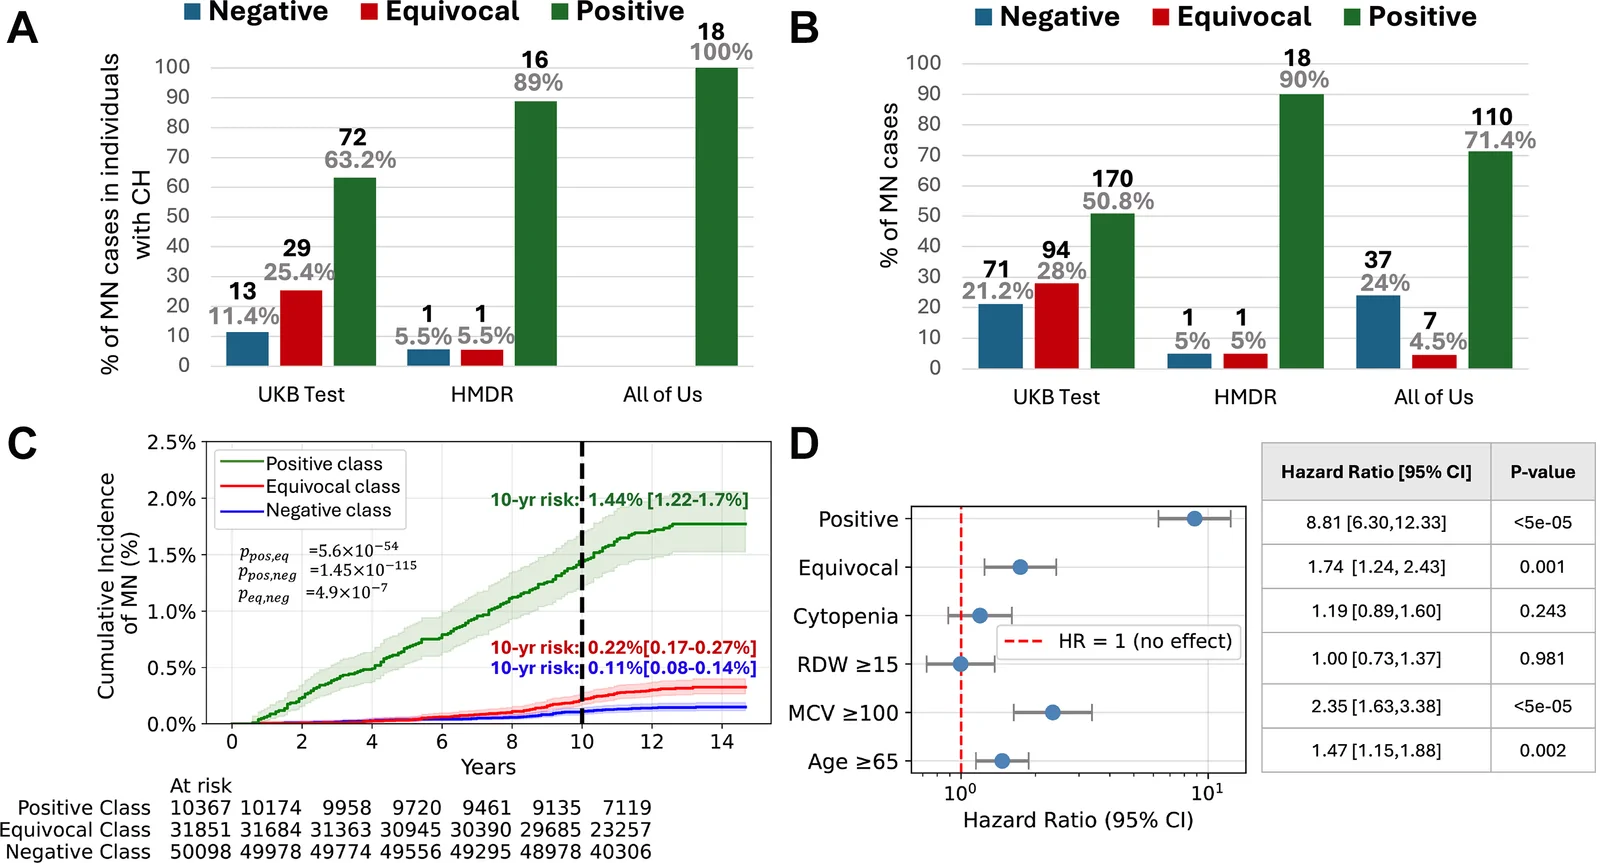
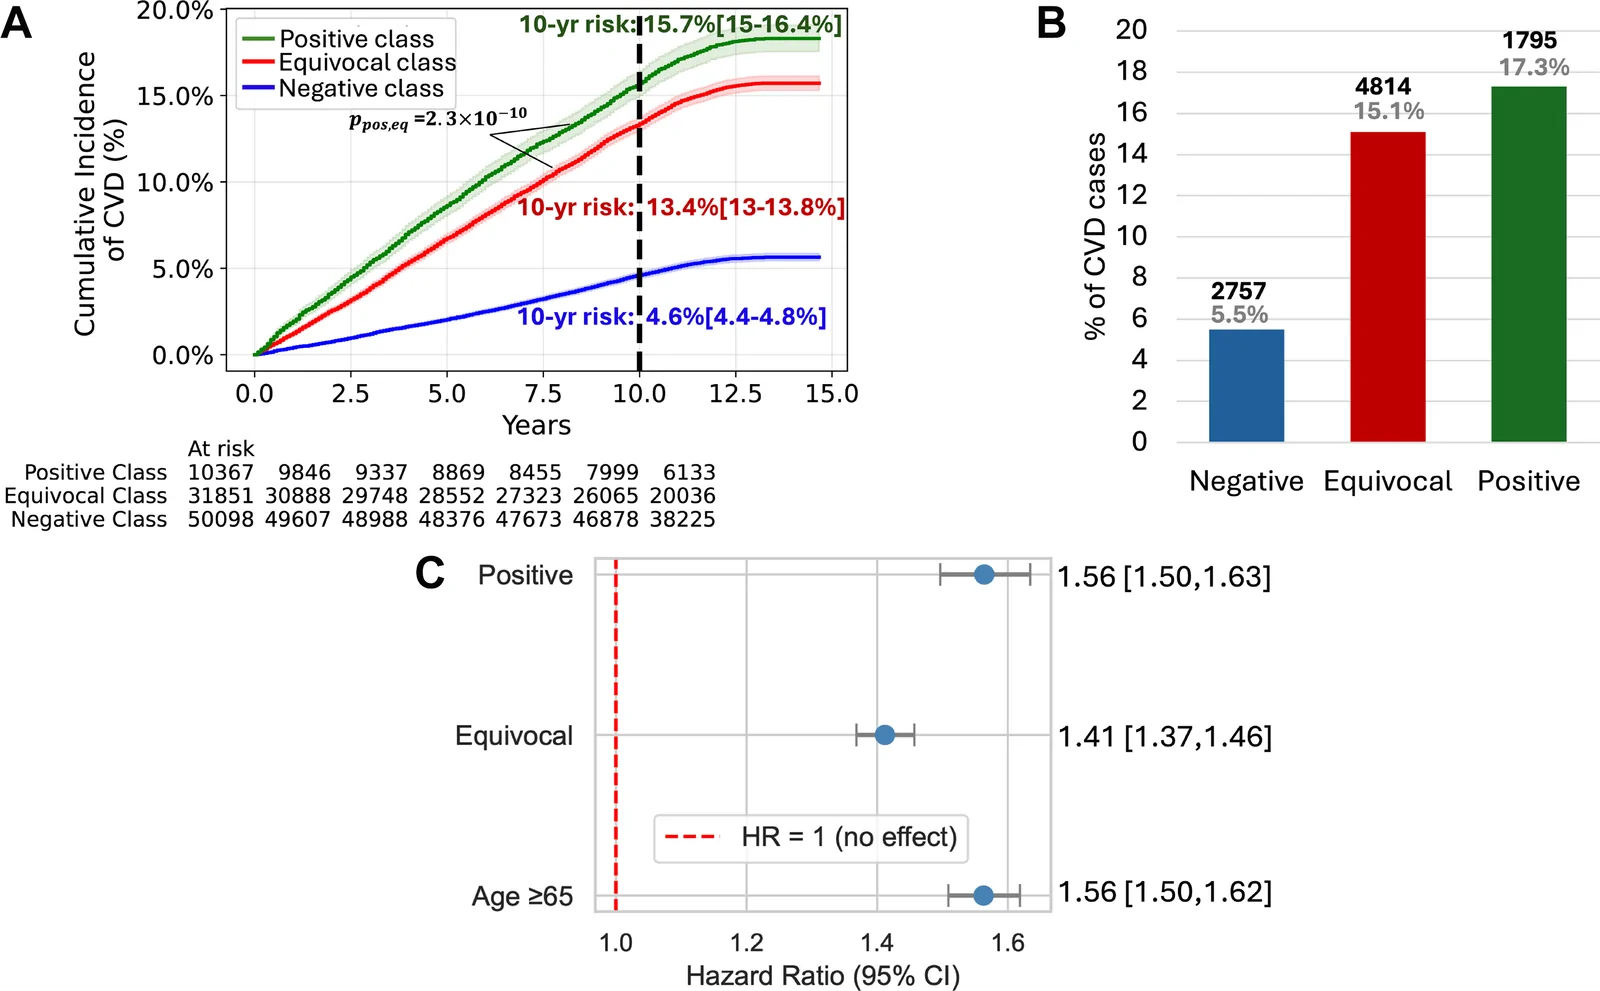
在随访中,PRISM分类还能预测髓系肿瘤的实际发生风险。图4显示,在最终发生髓系肿瘤的克隆造血个体中,PRISM如何分布其类别;而对所有个体而言,PRISM阳性类显著富集了未来髓系肿瘤事件。此外,图5还提示PRISM分类与心血管疾病事件累积发生率也存在关联,说明该模型捕捉到的血常规异常不仅指向血癌风险,也与非恶性结局有关。
方法亮点:从23项指标到精简模型,跨队列验证
PRISM的方法学设计有不少值得称道之处。研究者最初考虑了23项可用血常规参数加上年龄、性别作为候选特征。通过Spearman相关分析,他们剔除了与别的指标高度相关(相关系数≥0.9)的白细胞计数、血细胞比容和高散射网织红细胞计数,以降低多重共线性。由于外部验证队列缺少血小板分布宽度,他们还在UKB中定义“巨大血小板”阈值来替代该特征。
面对阳性类样本极少的不平衡问题,团队在训练折叠中动态采用合成少数类过采样(SMOTE)结合多数类随机欠采样,构造每类1000人、共3000人的平衡训练集来筛选模型架构。他们比较了九种分类器后,选定平衡随机森林(Balanced Random Forest)作为最佳算法;再用随机搜索调参、以10折交叉验证最大化宏平均召回率,并用Boruta算法剔除对决策非必需的性别、平均红细胞血红蛋白浓度、嗜碱性粒细胞计数等特征。最终还去掉了在外部数据中注释不一致的网织红细胞体积等参数。
模型训练使用UKB的369,260人(80%),内部测试使用未参与训练的92,316人(20%)。外部验证则来自两个差异很大的队列:HMDR是2010–2024年丹娜-法伯血液门诊2233例接受临床靶向panel测序的患者,代表临床高危场景;All of Us是2017–2023年美国人群队列,采用全基因组测序(平均深度约40×)判定克隆造血,代表社区人群场景。两个外部队列都有不同程度缺失的血常规参数,研究者用k近邻插补处理缺失值,从而保证模型在真实世界数据中的可用性。
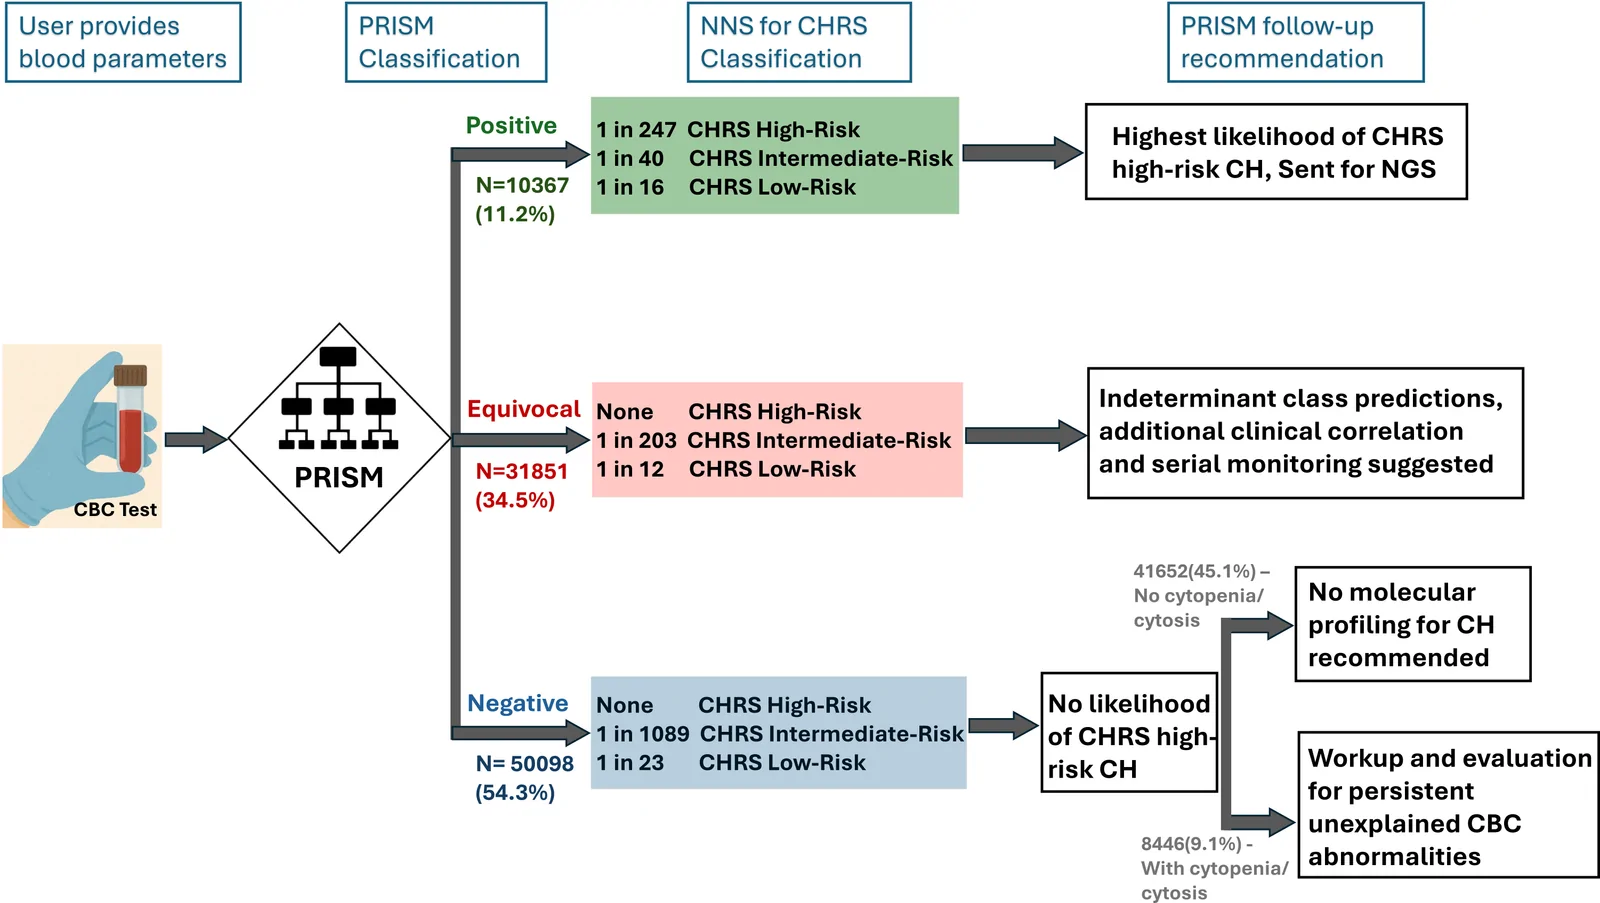
图6总结了PRISM在临床科研场景中的 proposed usage:先以常规CBC和人口学信息运行PRISM,再决定哪些人值得进入下游测序流程,从而把分子检测资源导向真正富集高危克隆造血的人群。
应用意义:首个经验证的“测序前”克隆造血模型
据作者在“研究背景”中的文献回顾,截至2025年12月31日,PubMed中尚无研究专门预测由CHRS等临床风险算法定义的高危克隆造血;虽有模型能预测特定克隆造血基因型,或用电子健康数据区分白血病前期与低危克隆造血,但没有经过验证的模型来指导“谁该接受克隆造血检测”。PRISM因此成为首个经过多队列验证的克隆造血测序前风险模型。
它的价值在于“便宜且可扩展”。血常规是全球医疗体系中最常规、最廉价的检测之一。PRISM只用CBC参数、年龄和性别,就能把人群预分为阳性、阴性和不确定三类:阳性者最可能携带高危克隆造血,应优先测序;阴性者NPV超过0.96,基本可排除高危状态,避免不必要的测序和过度诊断;不确定者则需结合更多信息判断。
对科研而言,PRISM为大型人群队列和直接面向消费者(DTC)的基因检测提供了决策框架:在投入昂贵测序前,先估计分子分型的潜在价值。对临床而言,它有助于把有限的基因组检测基础设施用在刀刃上,减少与年龄相关、临床后果有限的低危克隆造血被过度诊断。
当然,作者也指出,PRISM仍需进一步优化和前瞻性验证,才能成为患者、医生和消费者在面对临床、科研或新兴消费级克隆造血检测时的常规决策工具。但毫无疑问,这项研究把“血常规+机器学习”推到了血液肿瘤早筛的前沿:下一次评估克隆造血风险时,或许不必先做测序,先看一眼血象就够了。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。