文章中心
了解、体验、感悟、分享——汇聚平台使用教程与科研动态。
Hi-C测序要测多深?新研究给出各指标最低深度
原文:Systematic assessment of sequencing depth requirements for Hi-C-derived metrics.
期刊:BMC genomics(影响因子 3.9) | PubMed | PMC 全文(含 PDF)
Hi-C 技术已经成为研究基因组三维结构的核心工具。通过把染色质空间邻近关系转化为全基因组接触矩阵,研究者可以在不同尺度上读取基因组的折叠方式:在百万碱基(Mb)尺度上看到 A/B 区室(compartments),在亚 Mb 尺度上看到结构域和边界(insulation/boundaries),在更精细的千碱基(kb)尺度上看到染色质环(loops)。然而,一个长期困扰实验设计的问题是:要可靠地得到这些不同层次的指标,到底需要测多少条测序读段(read pairs)?
过去,很多高分辨率 Hi-C 分析动辄依赖数亿甚至数十亿条读段。但测序深度是实验可变成本的主要来源:文库制备有固定成本,而测序越深,每个样本的花费就线性上升。如果能明确“够用”的深度,就能把预算省下来,用于增加生物学重复、处理更多条件或扰动。近日发表在 BMC Genomics(影响因子 3.9)上的一项研究,系统评估了 Hi-C 衍生指标对测序深度的需求,给出了分层答案。
研究背景:不同指标,对深度的“胃口”不一样
Hi-C 接触矩阵里包含的信息跨越多个尺度。区室注释通常来自观测/期望矩阵的特征向量,分辨率较粗;绝缘分数(insulation)是围绕对角线局部窗口的接触密度,对局部读段数敏感;单个“点”或“环”则更局部,最难重复检测。而接触概率 P(s)——即相同基因组距离 s 上所有位点对的平均接触概率——是全基因组平均量,携带染色体聚合物状态和黏连蛋白(cohesin)介导环挤出统计特征的信息。
正因为不同指标使用的“平均程度”不同,它们对测序深度的敏感性本就不该一样。此前虽有研究关注重复性或特定环检测工具,但往往没有系统比较各类全局生物物理指标的最低深度,也常把“足够深度”定义为全深度的某个任意比例。本研究换了一个更自然的生物学标准。
核心发现:从“环密度”到“区室”,所需深度差十倍以上
研究者收集了 12 个人类 Hi-C 文库(来自 Oksuz 等和 Rao 等两项研究,涵盖两种细胞类型、两种交联protocol),把原始 FASTQ 读段从全深度逐步随机下采样到 2 亿、1 亿、5000 万、2500 万、1000 万和 100 万读段,并用同一流程(distiller-nf、cooler、cooltools 等)处理。
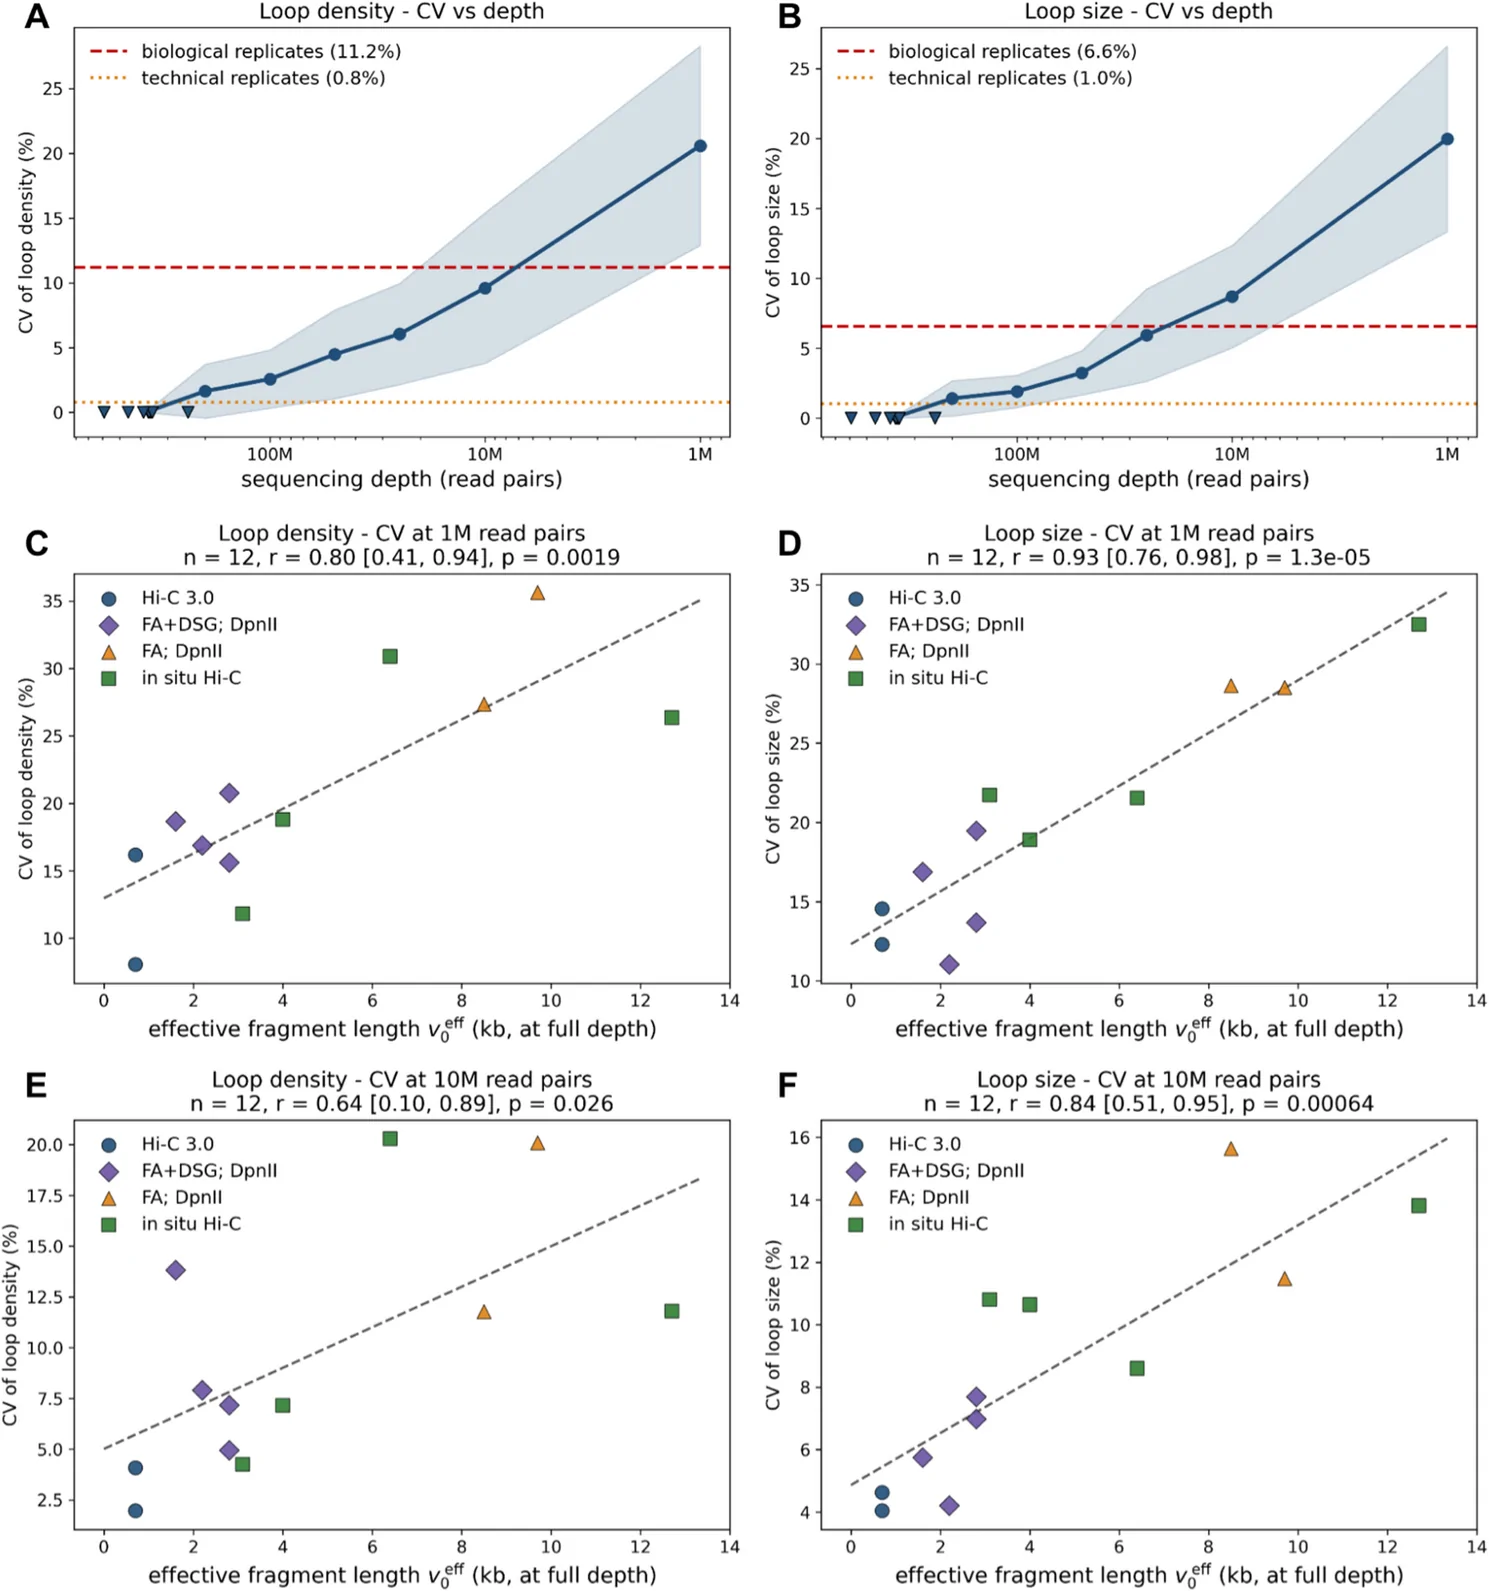
他们没有用“占全深度百分之多少”来定义足够深度,而是引入生物学重复变异下限:当随机下采样带来的离散度,首次达到同一细胞系独立生物学重复之间在全深度下的变异水平时,就认为该指标达到了再多测序也无法超越的准确极限。技术重复(同文库重测序)下限则更严格。
结果给出了清晰的层级:
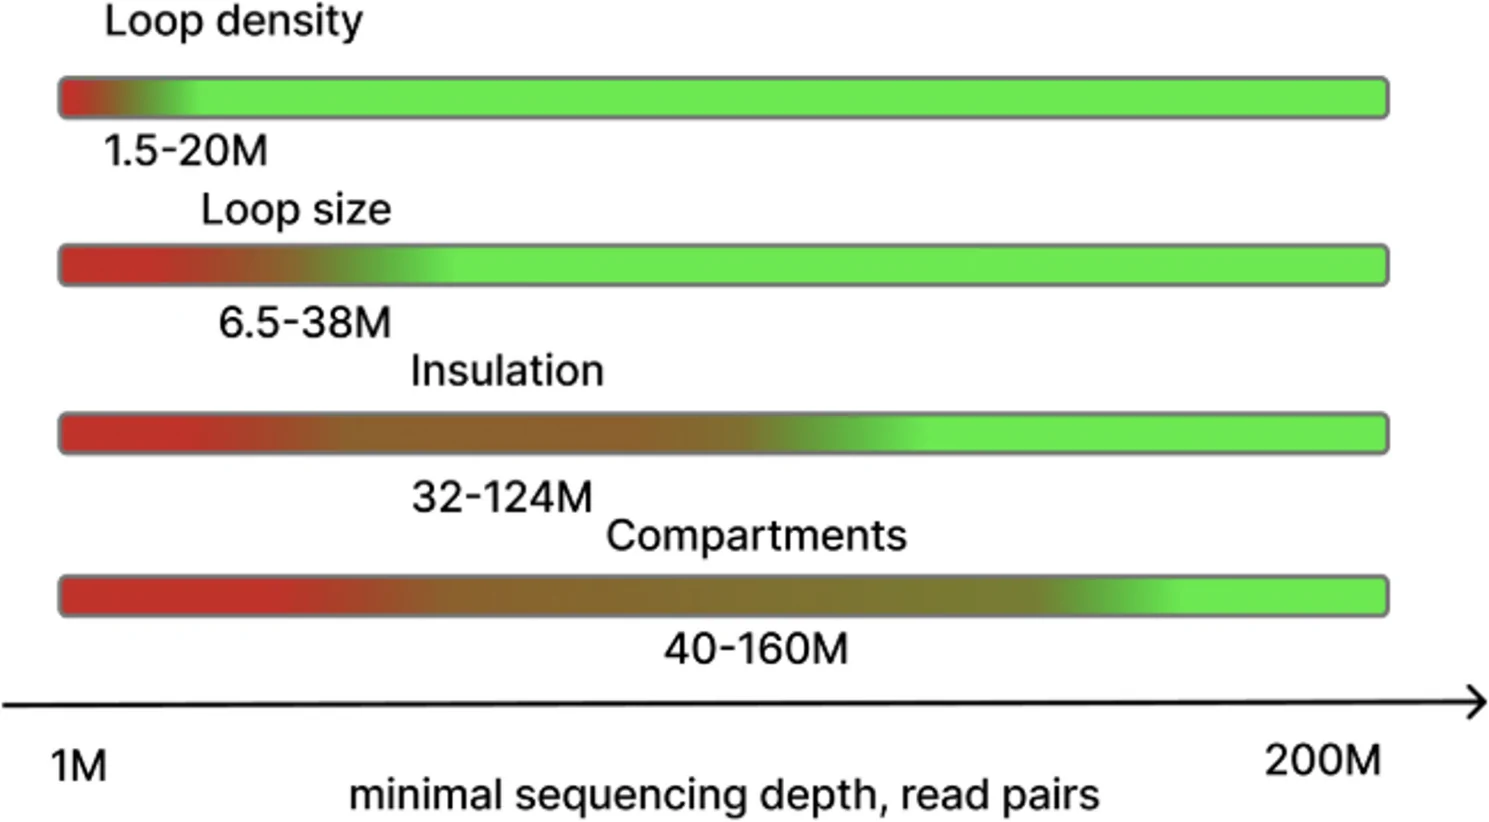
- 基因组平均环密度(loop density):来自 P(s) 对数导数短距离“凹陷(dip)”,约 700 万读段即达生物学下限。
- 基因组平均环大小(loop size):来自 P(s) 导数“峰值(peak)”位置,约 2000 万读段。
- 绝缘分数(insulation scores):约 8000 万读段。
- 100 kb 分辨率下的区室特征向量(compartment eigenvectors):约 1.1 亿读段。
也就是说,从环密度到区室,所需深度相差十倍以上。所有指标的深度诱导变异,都在远未达到全深度之前就降到了生物学重复变异之下。这些阈值适用于全基因组平均特征,而非特定位点的局部指标。
图 1 直观展示了 P(s) 衍生环特征的极端稳健性:一个全深度 3.57 亿读段的 hESC 文库,即便下采样到 100 万读段(约 350 倍稀释),其 log 导数在约 15 kb 的“dip”和约 74 kb 的“peak”仍视觉稳定。
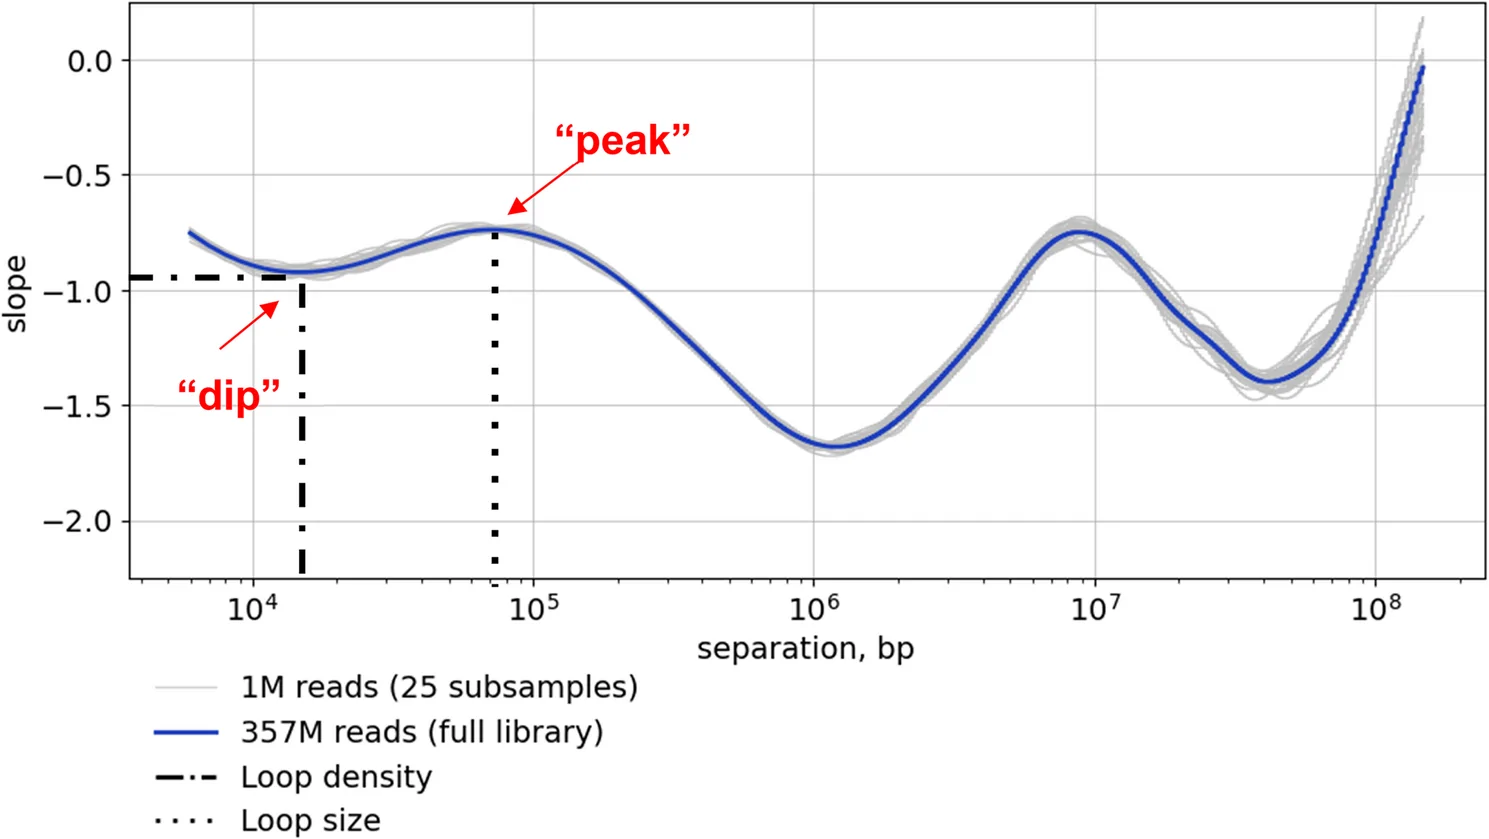
图 2 进一步量化了环密度与环大小在下采样中的变异系数(CV),显示两者分别在很低深度就触到重复噪声底。
对于区室指标,图 3 汇总了 9 个文库在 100 kb 分辨率下 E1 特征向量与全深度的相关性、A/B 符号匹配比例及区室强度随深度的变化;红色/黄色线标出生物学与技术重复下限。
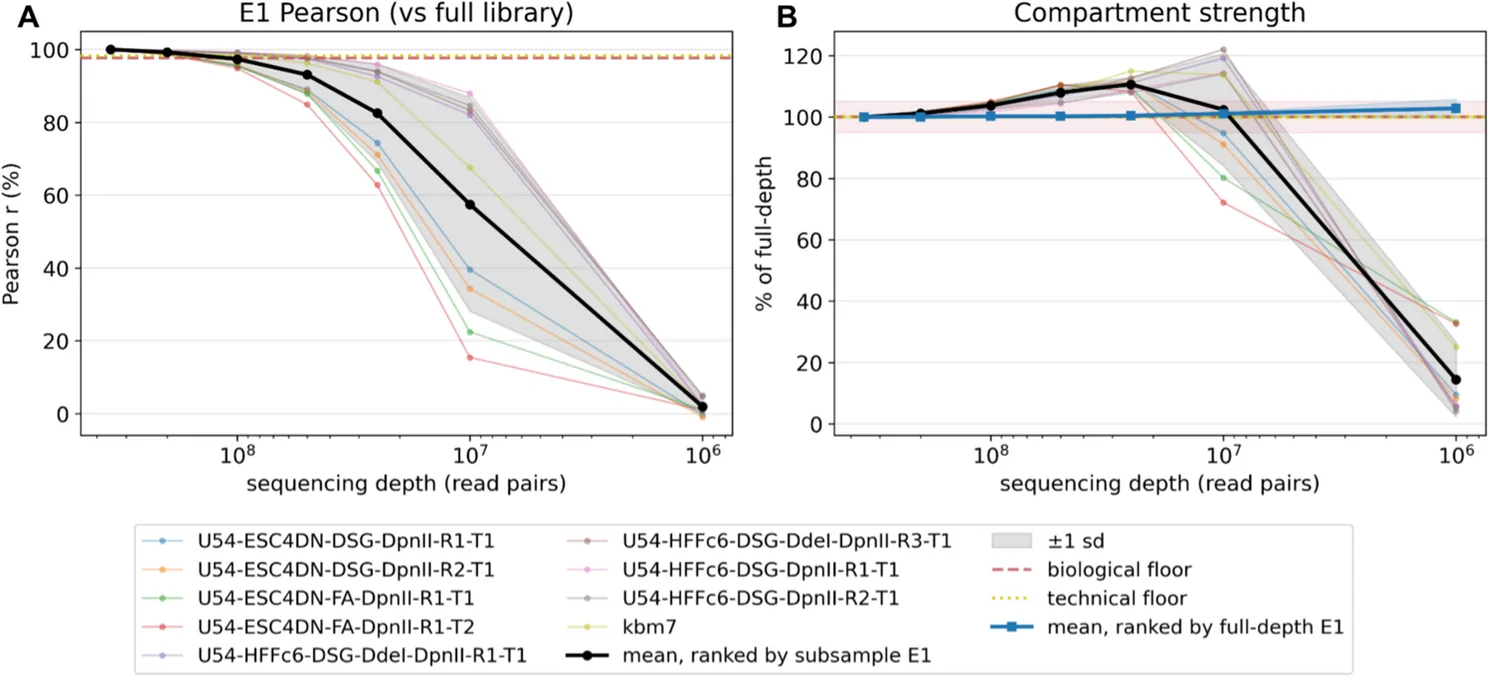
图 4 用 saddle plot 展示了一个 ESC 数据集在六个深度下的区室分离情况,说明即使降到 1000 万读段,区室结构仍可辨认,但要稳定达到重复水平需更深。
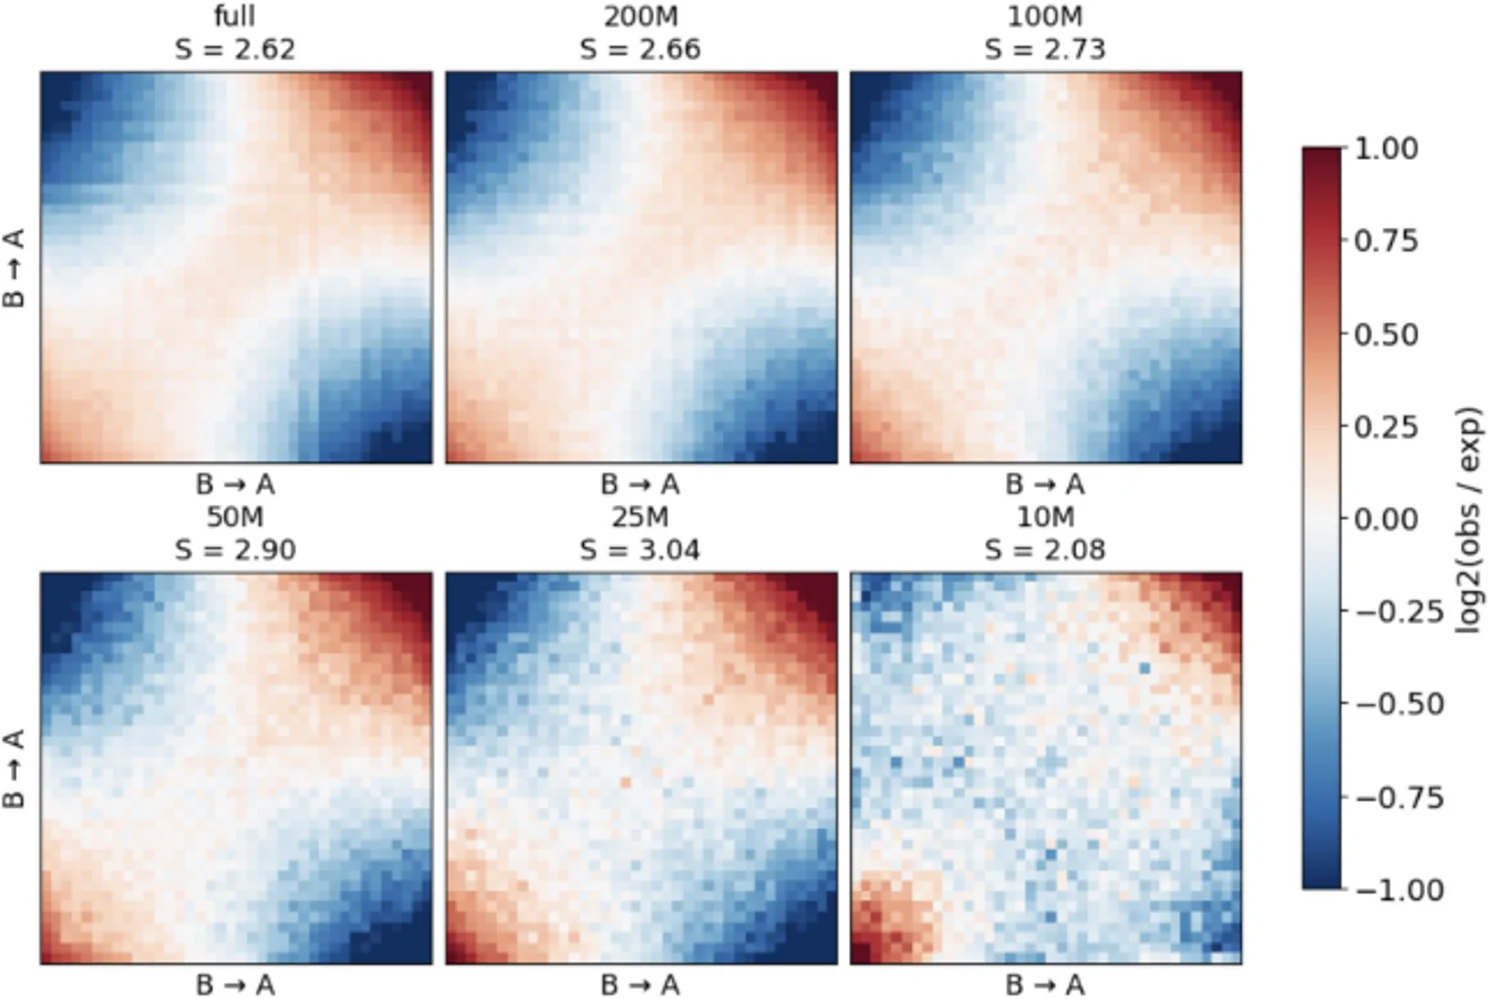
图 5 则给出绝缘与边界指标随深度的变化(9 个文库,100 kb 窗口、10 kb 分辨率),细线为单个文库,粗线为均值±标准差。
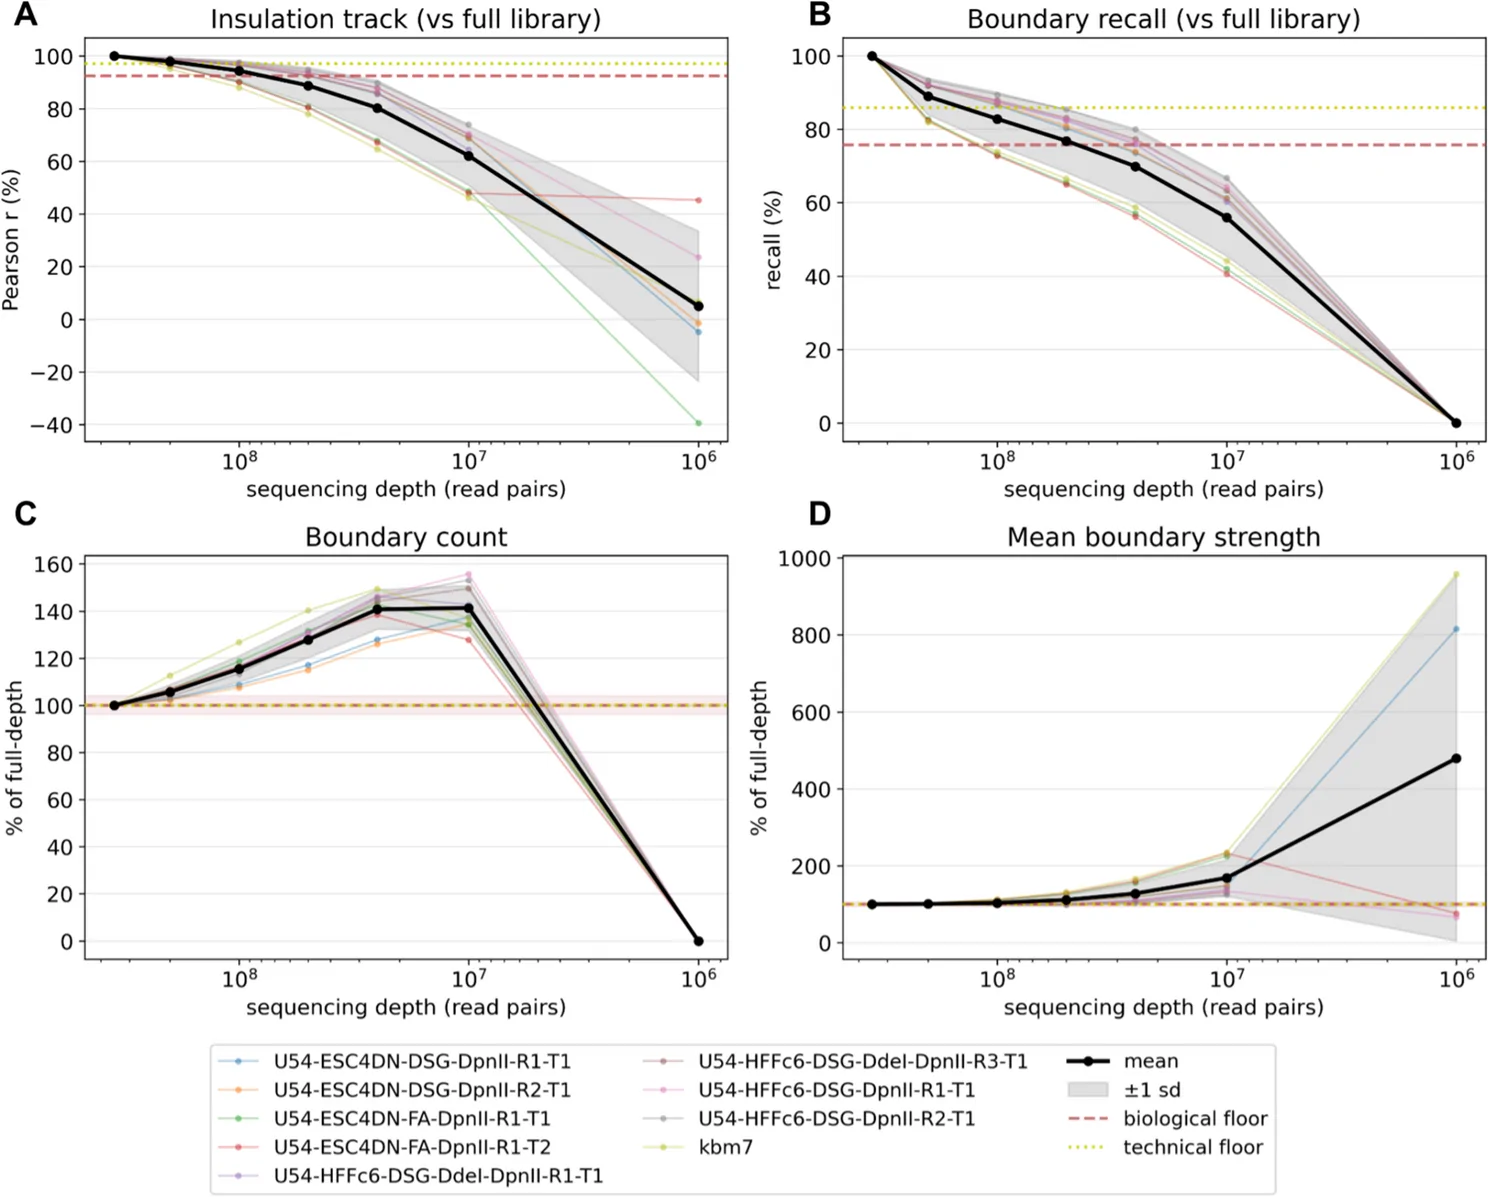
图 6 以示意图形式总结了各 Hi-C 指标家族的关键测序深度层级。
方法亮点:用“生物学重复”而非“全深度比例”定标准
这项工作的创新在于阈值定义方式。Hi-C 文库其实是从异质染色质构象集合中抽样有限亚群,而非单一确定状态。因此,不同指标本身就有不同的天然生物学可重复性:若某指标在独立重复间几乎一致,就需要极小的深度误差才算可靠;若某指标在重复间本就变化较大,则较低深度即可达到其可接受精度极限。
研究者对每个指标问的是:下采样散点何时变得与同细胞系全深度独立生物学重复间的变异相当?这一框架把测序深度选择从“任意百分比规则”变成针对具体指标、对照染色质折叠自然生物学变异的比较。此外,深度统一指原始测序读段数(下单时指定的量),下采样在比对前对 FASTQ 进行,因此直接反映真实测序预算。
具体计算上,P(s) 用 cooltools 的 expected_cis 在平衡计数上获得;dip 在 6–90 kb 窗口取斜率最小,peak 在 40–220 kb 窗口取最大,均在 1 kb bin 分辨。区室用 cooltools.eigs_cis 以 GC 含量定相,第一特征向量 E1 定向使 GC 富集为正(A 区室);绝缘用 10 kb 分辨率、100 kb 菱形窗口,边界调用采用 Li 阈值法。
应用意义:省下深度钱,多做生物学重复
该研究为全基因组实验设计和测序预算分配提供了实用指南。结论明确指出:对于全基因组平均的生物物理特征推断,增加生物学重复数量,往往比把单个文库测得更深更有效。例如,若研究目标是环挤出过程的全局统计(环密度、环大小),几千万读段已足够;若关注区室或绝缘,则需上亿读段;但若目标是特定位点的单个环或差异环检测,则可能需要极深图谱甚至数十亿接触——那是另一类局部问题。
对生物医学科研读者而言,这意味着在设计三维基因组项目时,应先明确主要读出指标是什么,再据此分配测序资源:把省下的可变测序成本用于更多条件、扰动或独立重复,从而提升统计功效与结论稳健性。在临床或疾病队列研究中,这种策略尤其有助于在有限预算下扩大样本量,捕捉群体水平的染色质结构变异。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。