文章中心
了解、体验、感悟、分享——汇聚平台使用教程与科研动态。
近红外光谱结合双线性曲面模型同步检测全麦粉面筋品质
原文:Bilinear surface model-enhanced determination of gluten quality in whole wheat flour by NIR spectroscopy.
期刊:Food chemistry: X(影响因子 9.2) | PubMed | PMC 全文(含 PDF)
关键图表
在现代健康饮食体系中,全麦粉因保留了麦粒的胚乳、麸皮和胚芽等全部天然营养成分,成为面包、饼干、披萨等多种烘焙食品的重要基础原料。然而,决定全麦粉加工适性的关键并不只是“营养全不全”,更在于其中面筋(gluten)的“量”与“质”。
面筋主要由麦谷蛋白和醇溶蛋白组成。所谓面筋含量,是指面筋蛋白在全麦粉中的质量百分比,反映其“数量属性”;而面筋强度,则指面筋网络在受力时抵抗变形和弹性恢复的能力,反映其“质量属性”。按照基于面筋指数(gluten index, GI)的分类标准,面筋强度通常被划分为弱(<30%)、正常(30%–80%)和强(>80%)三类。高含量、高强度的面筋适合制作需要良好持气性和韧性咀嚼结构的面包、披萨;而低含量、弱强度的面筋则更适合饼干、酥饼等要求酥软口感的产品。
在小麦品种育种和品质筛查中,湿面筋含量(WGC)、14%水分基校正湿面筋含量(WGC(14% MB))、干面筋含量(DGC)等反映“含量”的指标,以及筛上湿面筋(WGS)和面筋指数(GI)等反映“强度”的指标,都是区分不同小麦品种加工适宜性的核心依据。但按照国家标准 GB/T 5506.2-2024 与 GB/T 5506.4-2008 的湿面筋、干面筋测定流程,操作繁琐、耗时长、对实验人员技能要求高,且具有破坏性,还要消耗大量样品和化学试剂,难以满足现代粮食加工企业对原料快速在线分级、工艺实时调整,以及育种领域大规模基因型筛查的迫切需求。
研究背景:为什么需要快速无损检测技术
近红外光谱(NIR)技术因其快速、无损、高效的特点,已被广泛用于食品品质检测和表型分析,也用于小麦面粉中面筋含量与强度的评估。已有研究采用傅里叶变换中红外光声光谱结合化学计量学方法测定小麦粉总蛋白和湿面筋含量,或使用不同模型配置预测蛋白与面筋指标,但多数研究采用多个模型分别预测不同指标,并不是理想的一体化技术方案。
更重要的是,以往关于面筋品质检测的研究主要集中在小麦粉和麦粒上,对全麦粉这一完整研磨物料关注相对有限。全麦粉因含有麸皮和胚芽,基质更为复杂,给光谱建模带来额外挑战。因此,如何在一台便携式近红外设备上,仅凭一次光谱扫描就同时预测全麦粉中多个面筋“含量”与“强度”指标,成为该研究要解决的核心问题。
核心发现:一套模型同时预测五项面筋指标
发表于《Food Chemistry: X》(影响因子 9.2)的这项研究,题为“Bilinear surface model-enhanced determination of gluten quality in whole wheat flour by NIR spectroscopy”,提出了一种基于近红外光谱的全麦粉面筋品质同步检测新框架。
研究团队以北京顺义区(40.13° N, 116.65° E)种植的 100 个小麦品种为材料,经北京市小麦种子检测中心通过 SSR 分子标记(NY/T 2859-2015)鉴定验证后,用实验室磨将麦粒研磨成符合 GB/T 5506.2-2024 粒度规格(如 100% 通过 710 μm 筛)的全麦粉。随后使用手持式便携近红外光谱仪 DLP® NIRscan™ Nano,在 930–1630 nm 波长范围、2.34 nm 波长间隔下采集光谱,得到 389 个光谱维度;每个样品分五组随机取点、每点扫描三次,最终以十次测量的均值作为分析光谱。
在指标测定方面,研究严格依据国标:称取 10 g 面粉样品(m1),与 20 g/L NaCl 溶液(22°C ± 2°C)混合 20 s 形成面团,再用 NaCl 溶液通过 88 μm 筛洗涤 2 min 得到湿面筋(m2),从而计算 WGC;经 14% 水分基校正得到 WGC(14% MB);湿面筋经 150–200°C 干燥 300 s 后称重得到干面筋质量(m4),计算 DGC;湿面筋在 6000 r/min 下离心 60 s,通过 600 μm 筛筒,称取过筛质量(m3),得到筛上湿面筋 WGS = m2 − m3,并计算 GI = (m2 − m3)/m2。
结果显示,研究所提出的新型建模方法结合 CARS-LASSO 算法取得了最优预测效果:对 WGS、GI、DGC、WGC 和 WGC(14% MB) 五项指标,测试集决定系数 R² 分别达到 0.98、0.93、0.89、0.84 和 0.83;相对分析误差 RPD 分别为 6.73、3.77、3.08、2.47 和 2.40。这意味着该模型不仅对面筋“强度”相关指标(WGS、GI)具有极高预测精度,对“含量”相关指标也达到了可用于实际筛查的水平。
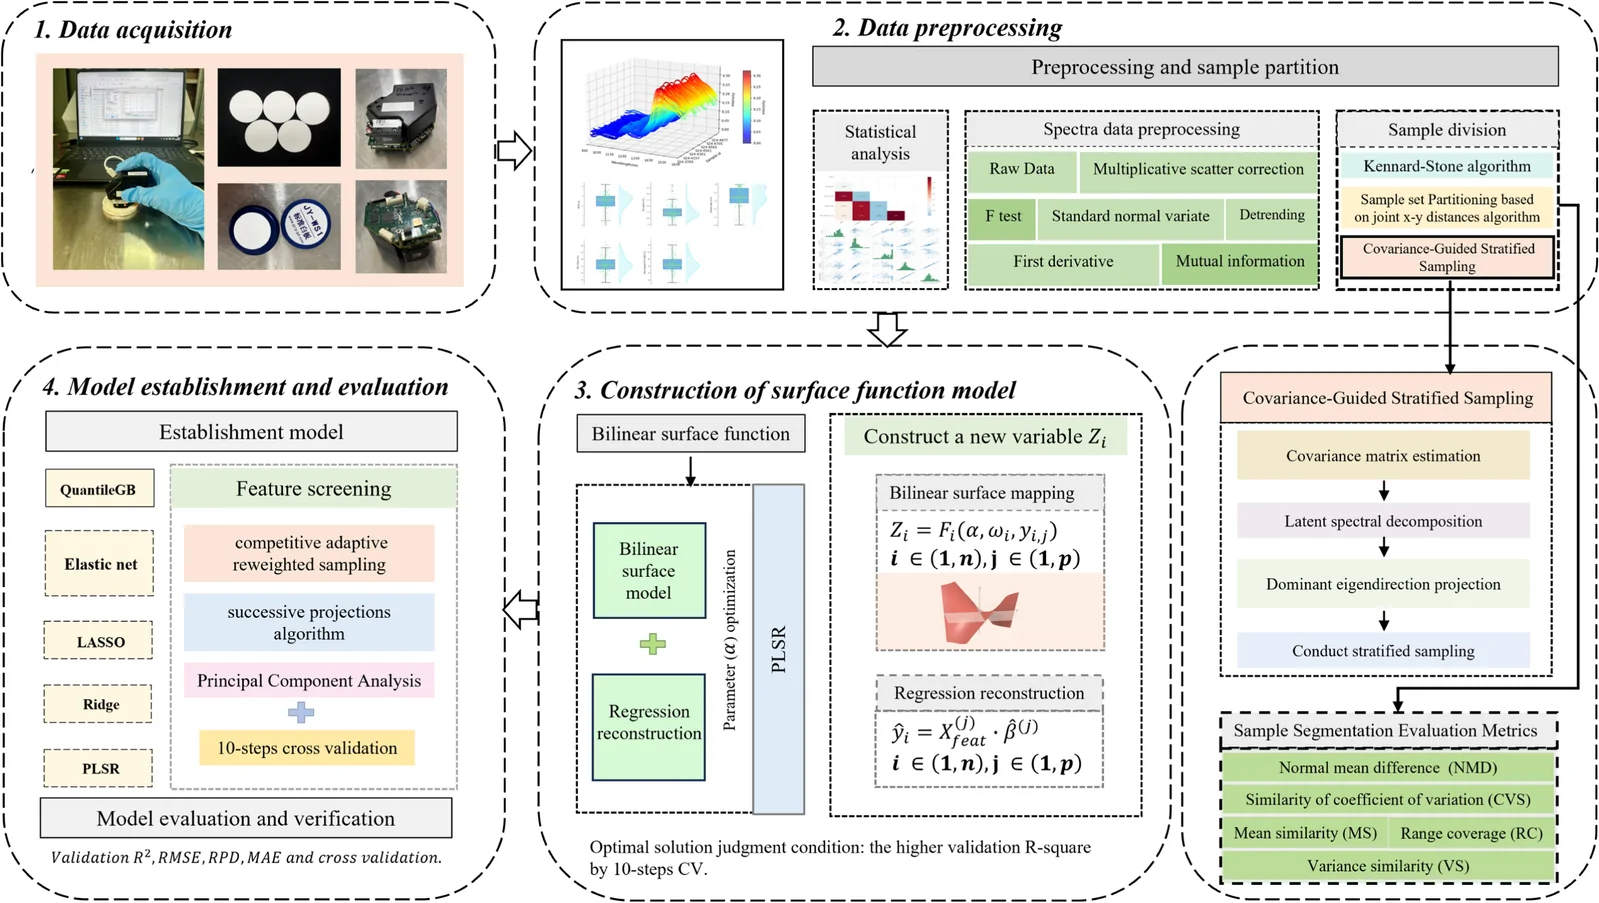
方法亮点一:协方差引导的分层抽样(CGSS)
在光谱建模中,如何把有限样本划分为训练集和测试集非常关键。传统 Kennard–Stone(KS)算法依赖欧氏距离最大化多维空间覆盖;SPXY 方法进一步把光谱空间 X 和目标空间 Y 的距离结合进来。但两者都基于欧氏距离,隐含假设各维度相互独立。而在多指标场景下,多个品质指标之间天然相关,这种距离度量可能无法充分捕捉输出空间的联合信息。
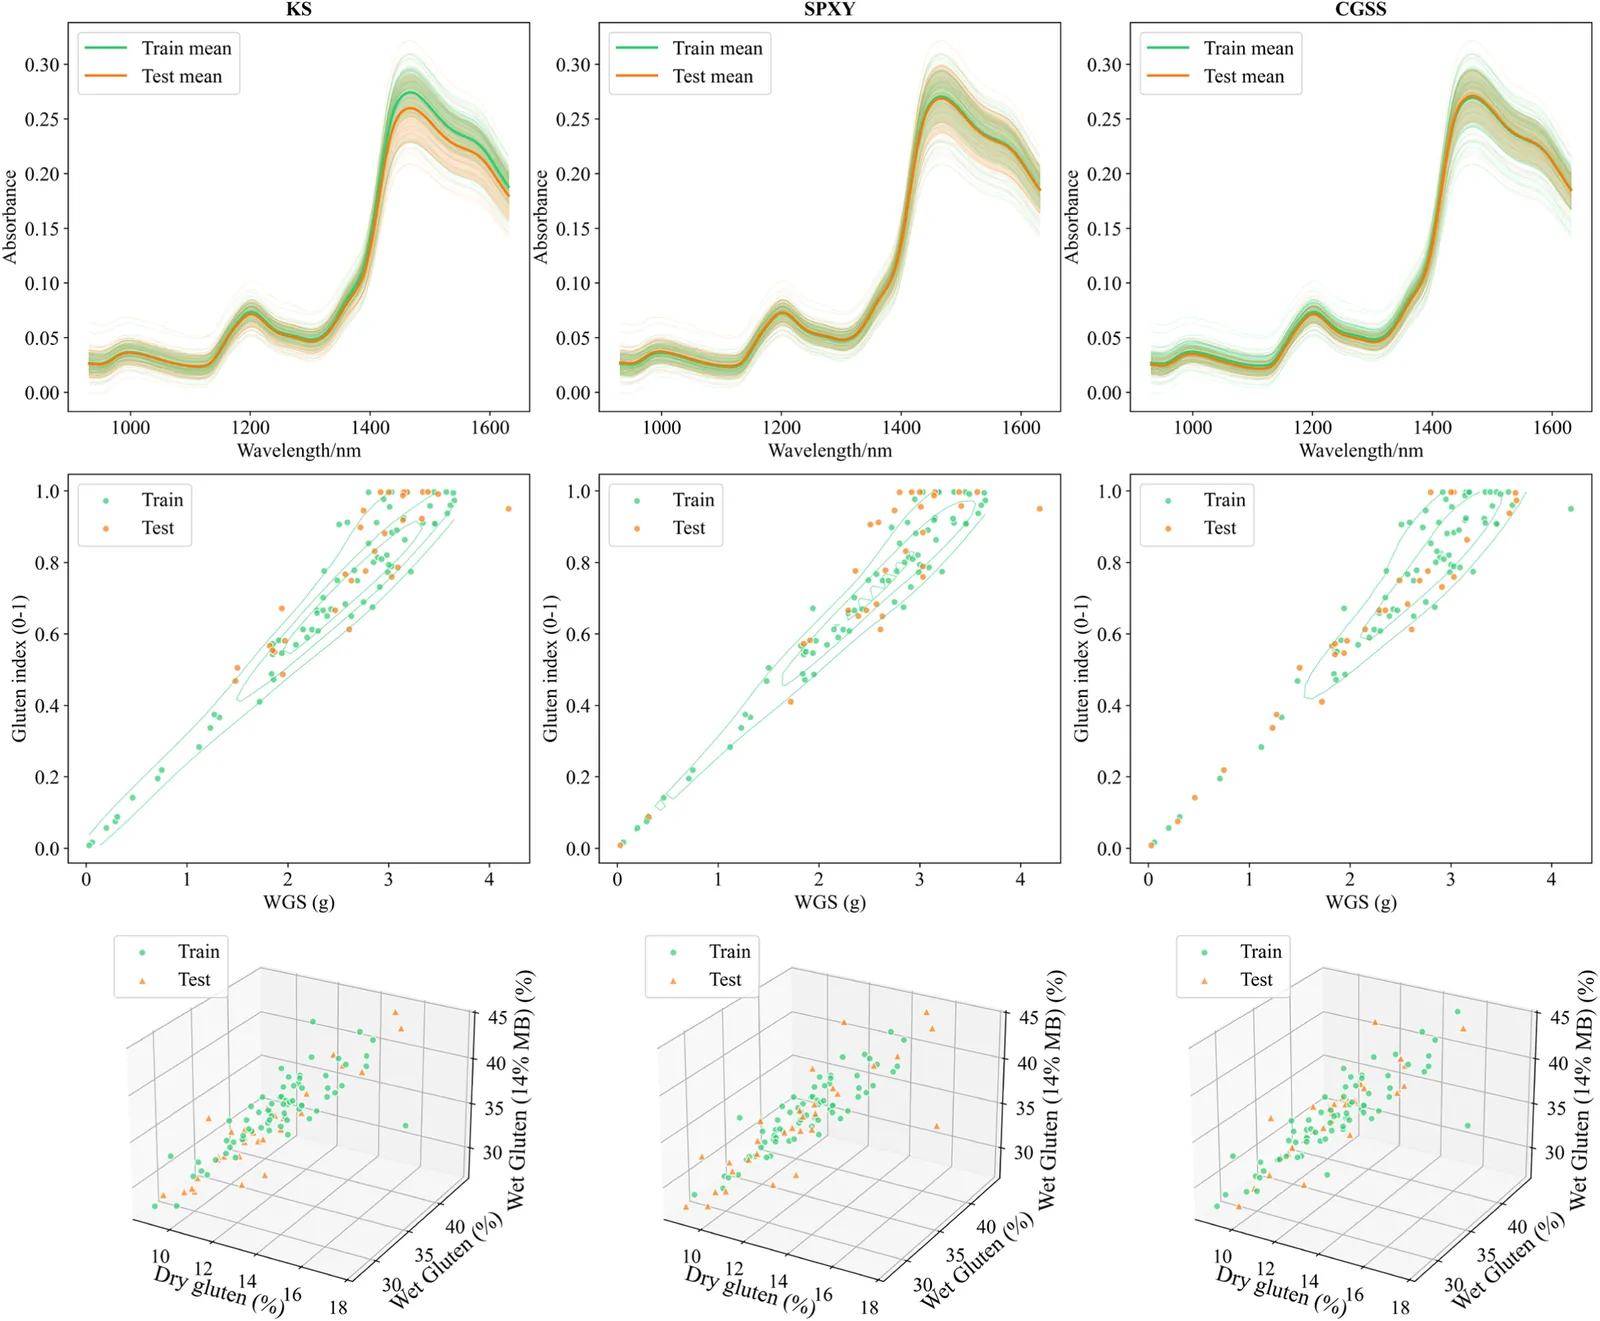
为此,研究提出了协方差引导的分层抽样(covariance-guided stratified sampling, CGSS)算法。该方法先计算响应矩阵 Y 的协方差矩阵 Σ,再通过谱分解 Σ = WΛWᵀ 揭示其潜在几何结构;其中最大特征值对应的主特征方向 w1 捕捉了多个相关响应变量联合变化的主轴,并定义一维综合得分 si = w1ᵀ(yi − ȳ)。与假设维度不相关的距离度量不同,CGSS 在划分过程中显式考虑了响应矩阵的协方差结构,从而保留了多响应变量之间的内在相关性。
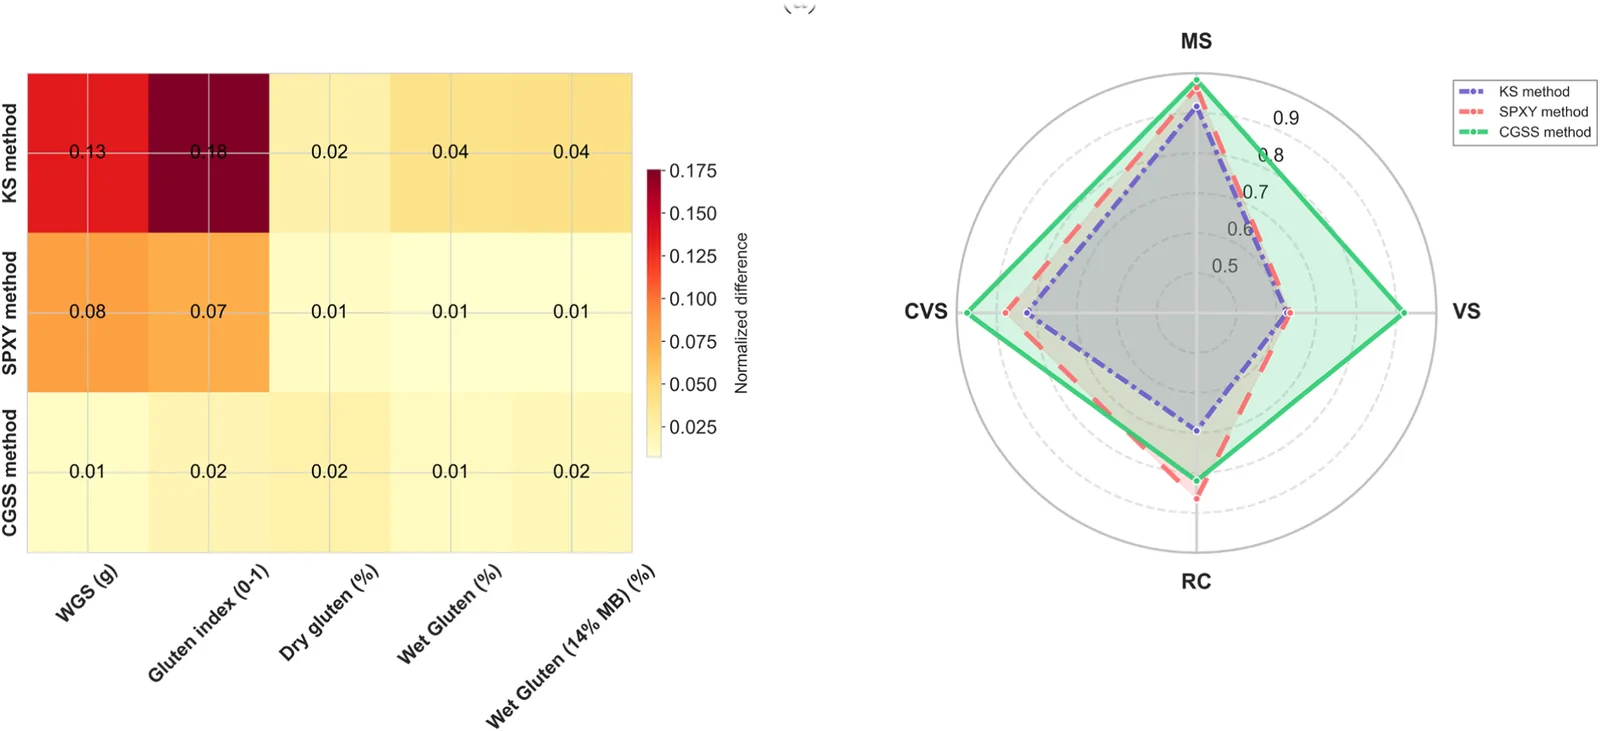
研究将 100 个全麦粉样品按 7:3 划分为训练集和测试集,并用归一化均值差(NMD)、均值相似度(MS)、方差相似度(VS)、范围覆盖度(RC)和变异系数相似度(CVS)五项指标评估两组分布一致性。CGSS 在小样本、多指标条件下展现出更合理的样本代表性。
方法亮点二:双线性曲面模型与机器学习耦合
研究的另一项核心创新是构建了双线性曲面模型(bilinear surface model)。对于 n 个样品的第 j 个目标变量 y(j),先计算标准化位置 xi 和归一化目标值 ỹi(j),并基于先验知识分配权重 wi(j)。通过构造曲面函数,得到变换变量 Fi(j),将原始目标变量 yi(j) 转换为 Fi(α, ωi, yi(j)),其中 α 为超参数。
具体变换形式为:F = Y ⊙ (1n×p + α · W ⊙ Ȳ),即 Fi(j) = yi(j) · [1 + α · wi(j) · ȳi(j)]。随后通过带 L2 正则化的回归方程,从特征矩阵 Xfeat(j) = [F(j), x, F(j) ⊙ x] 重构出预测值 ŷi(j)。偏最小二乘(PLS)回归结合 10 折交叉验证被用于确定最优参数 α。
在光谱预处理方面,研究比较了多元散射校正(MSC)、标准正态变量变换(SNV)、一阶导数(1D)和去趋势(Detrending)等方法,以测试集最高 R² 为准选择最优预处理。在降维方面,采用竞争性自适应重加权采样(CARS)、连续投影算法(SPA)和主成分分析(PCA)提取特征,并结合十种机器学习模型与 10 折交叉验证进行建模预测。
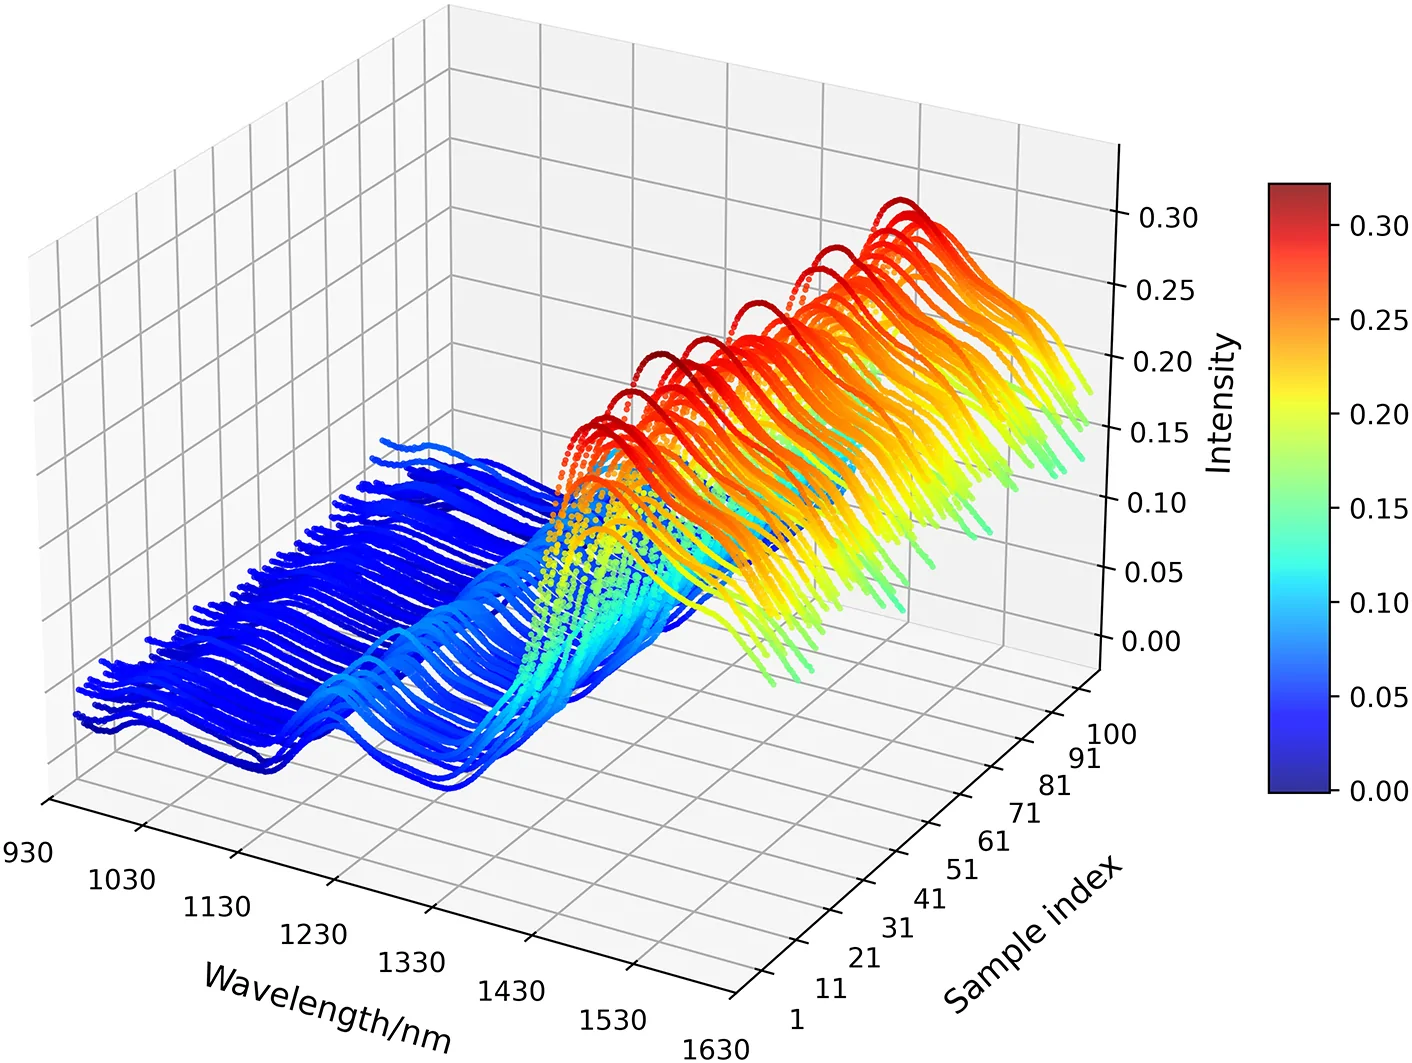
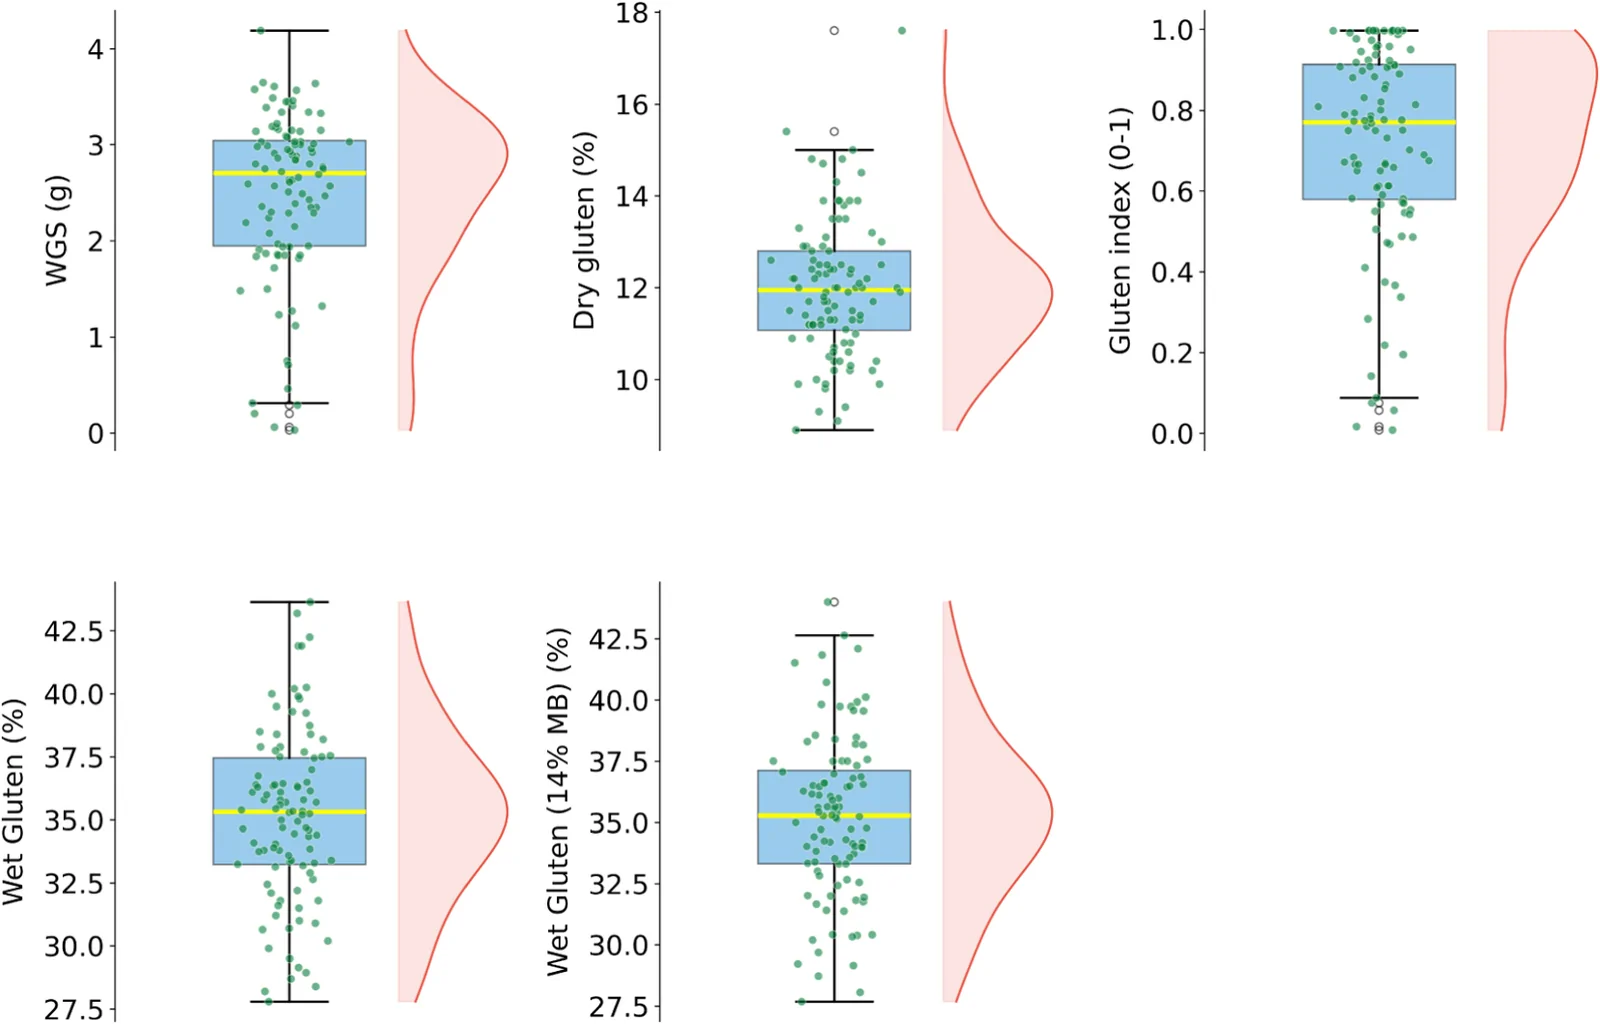
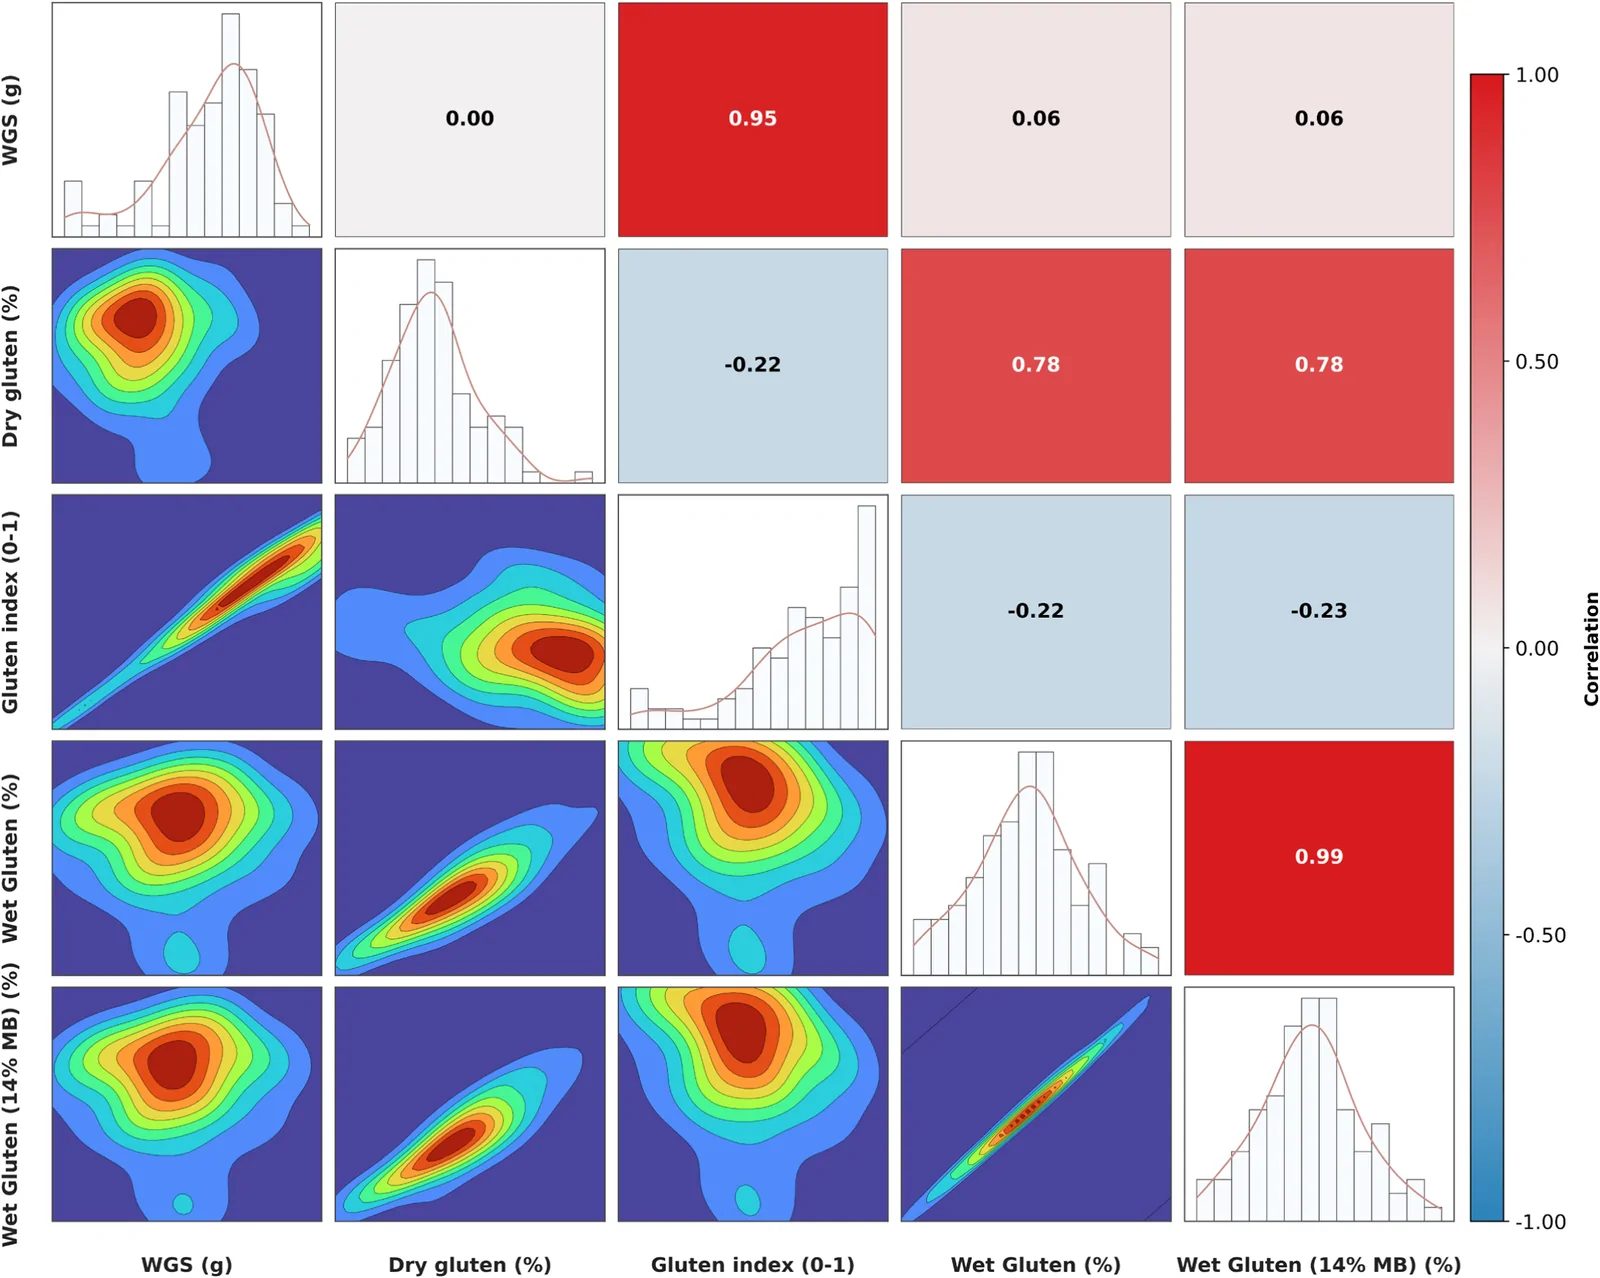
最终结果表明,双线性曲面模型与 CARS 降维及 LASSO 机器学习算法相结合时表现最佳。研究还系统比较了五种机器学习算法在 SPA、CARS 和 PCA 三种降维特征下耦合双线性曲面模型的性能差异,进一步验证了该框架在多指标同步预测中的稳健性。
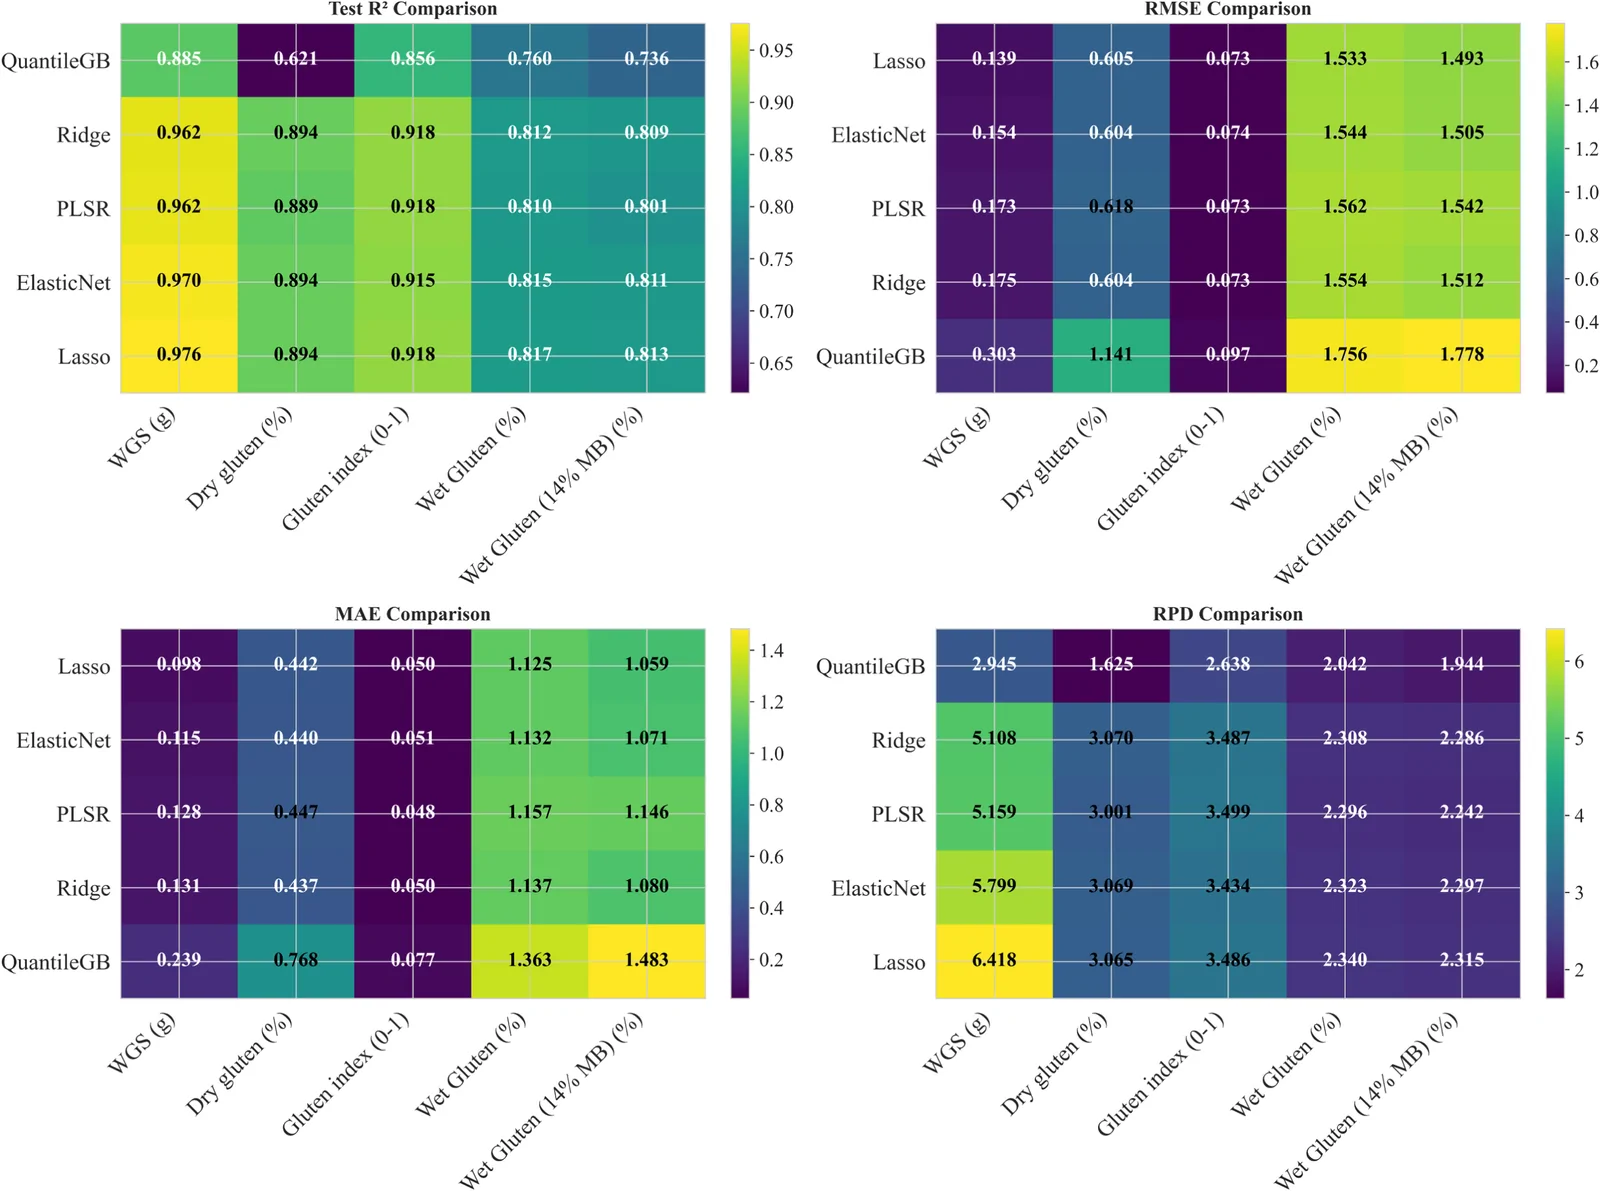
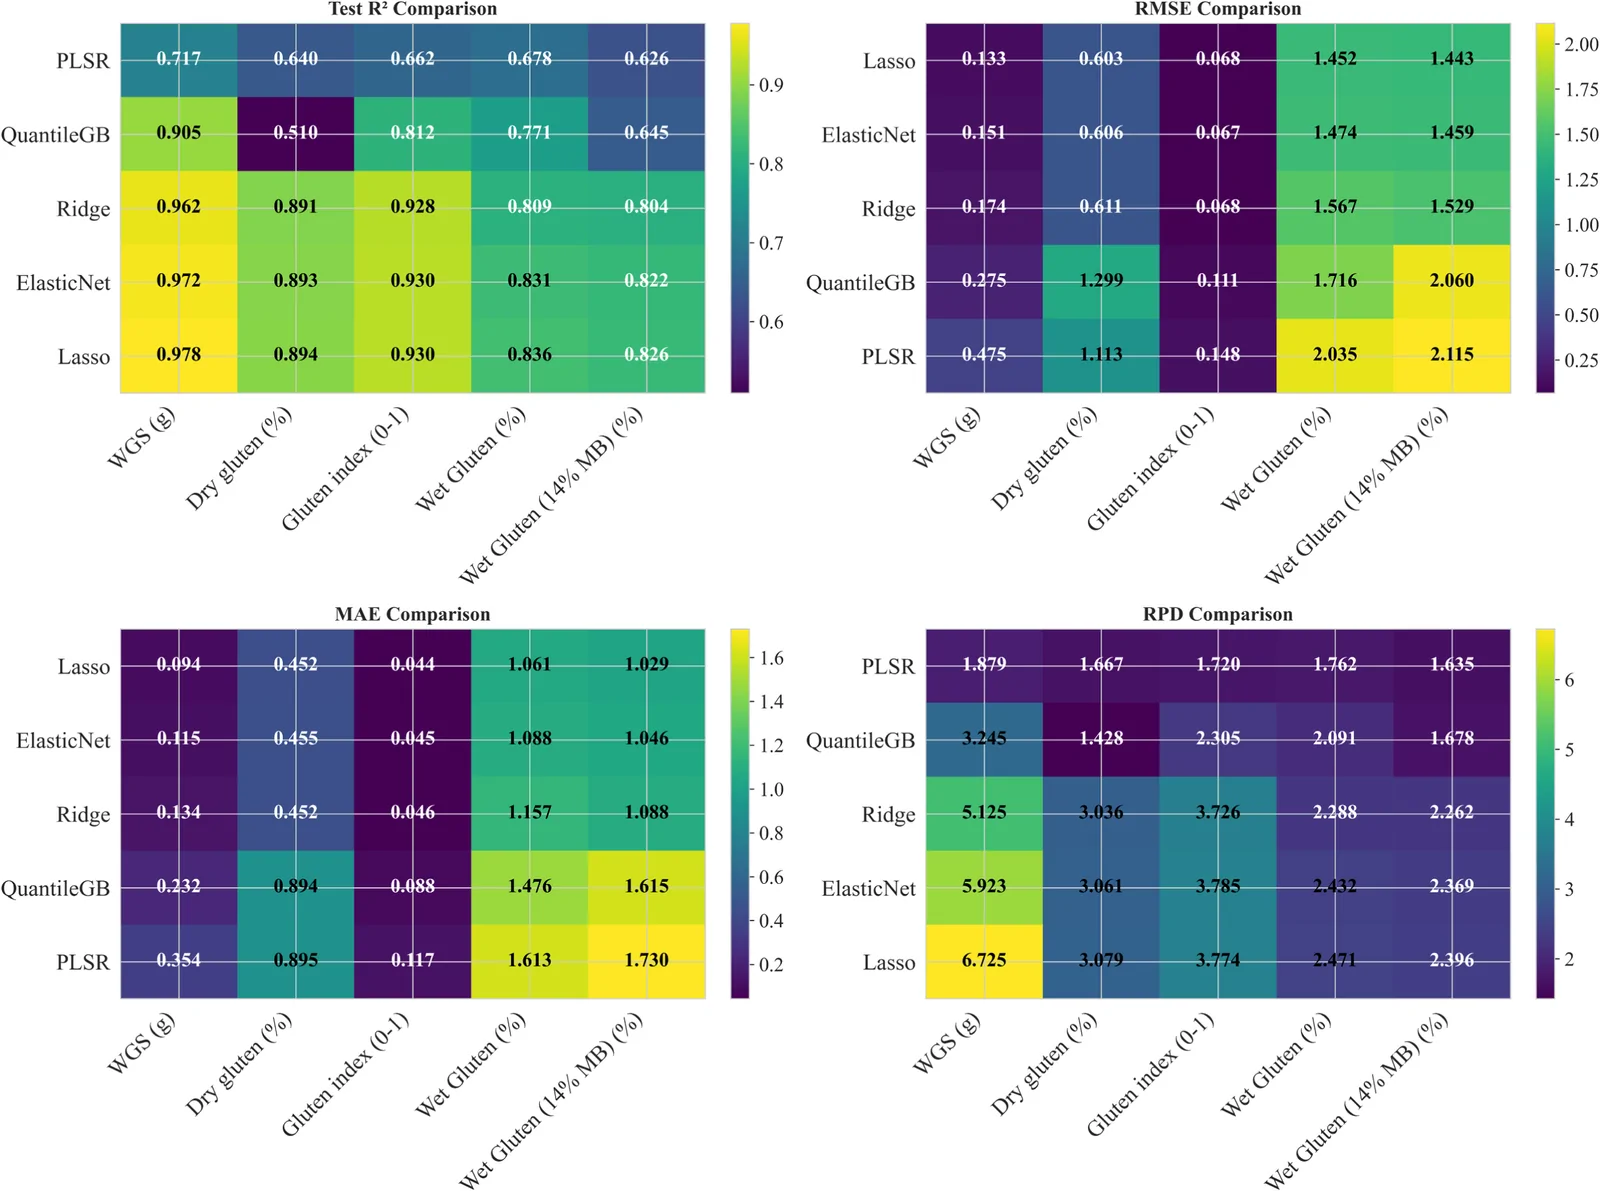
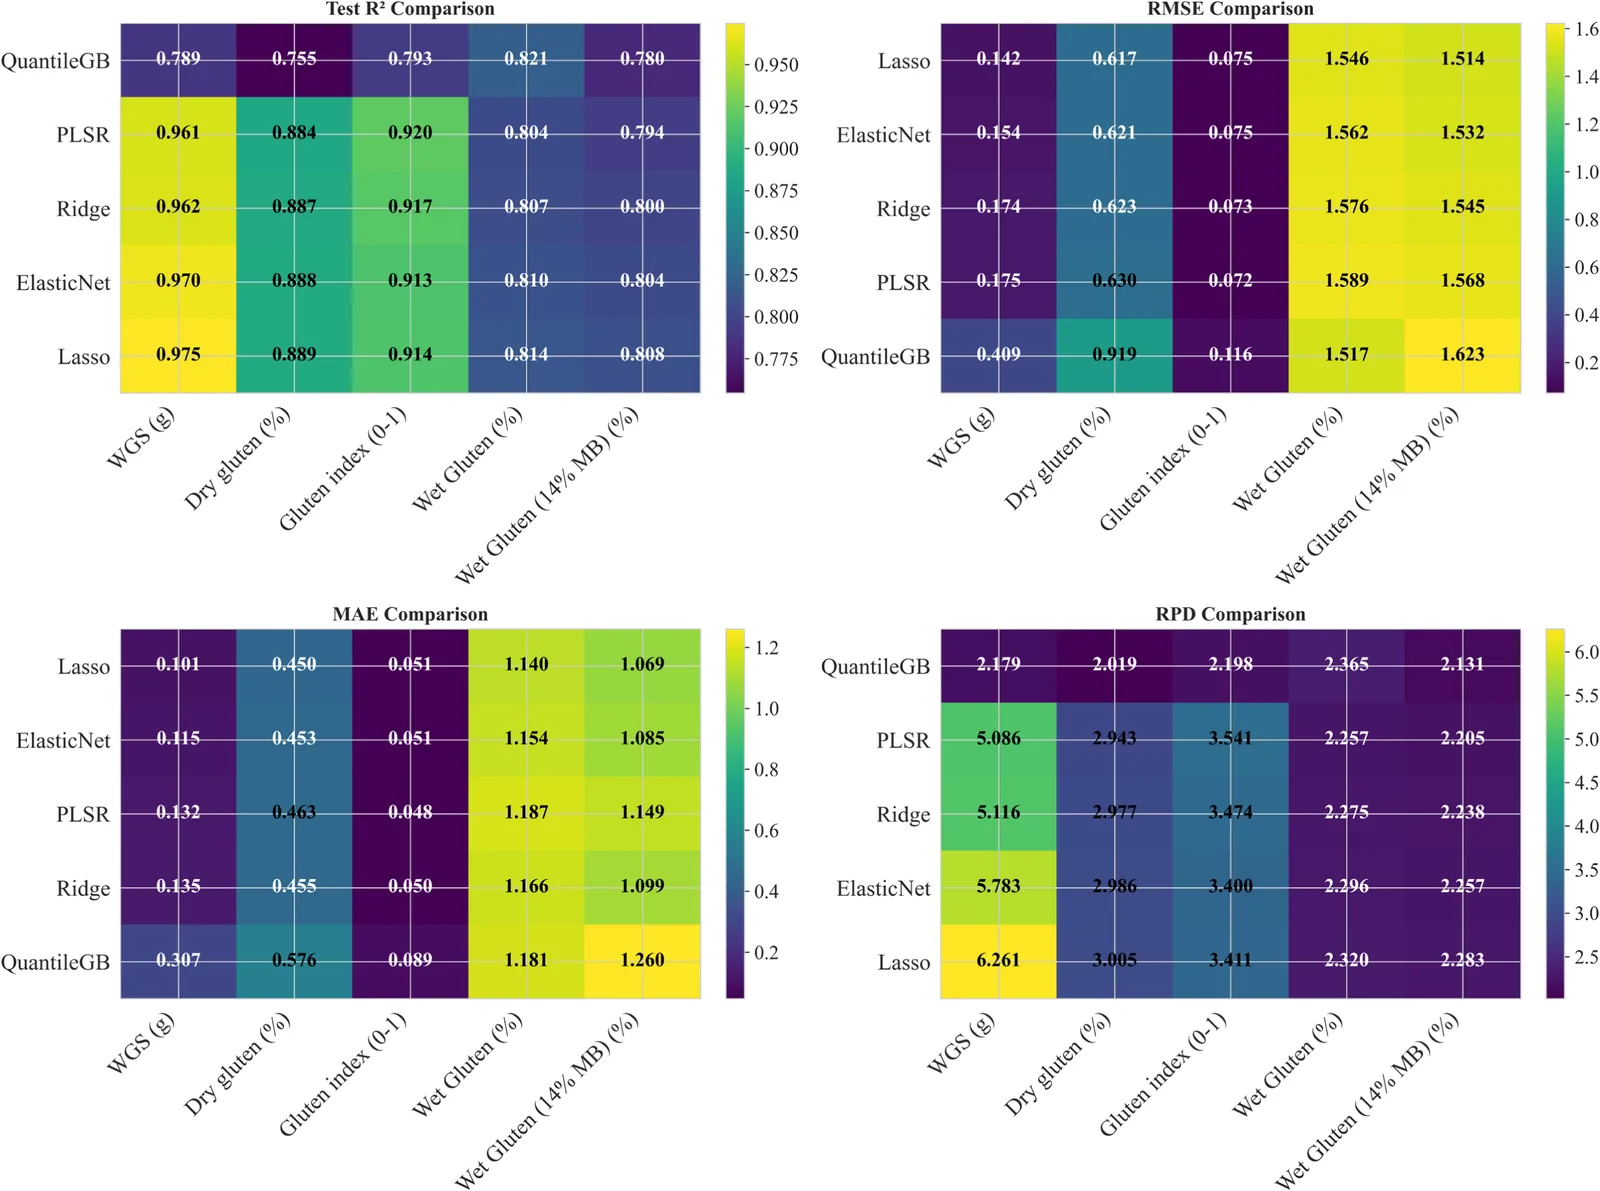
应用意义:从实验室走向育种与加工现场
这项研究的价值不仅在于方法学上的创新,更在于其明确的落地场景。首先,在小麦品种育种中,传统面筋指标测定需要破坏样品、耗时费力,难以对大量育种材料进行高通量筛查。该研究使用手持式便携近红外光谱仪,配合统一模型同时输出五项面筋指标,有望加速优质专用小麦品种的选育进程。
其次,在粮食加工与品质控制环节,企业可借助该无损、快速检测方案对进厂原料进行在线分级,并根据面筋含量与强度实时调整工艺参数,例如区分适合做面包的高筋全麦粉与适合做饼干的低筋全麦粉。
最后,从更广泛的生物医学与食品表型研究视角看,该工作展示了一种“小样本 + 多相关指标 + 光谱数据”的通用建模范式:通过 CGSS 解决样本划分中的相关性丢失问题,通过双线性曲面模型显式编码目标变量间的先验结构,再与机器学习降维和回归工具耦合。这一思路不仅适用于全麦粉面筋检测,也可为其他复杂基质食品、农产品乃至生物样本的多组分同步无损分析提供参考。
总体而言,该研究以 100 个小麦品种的全麦粉为对象,用便携式近红外光谱结合协方差引导分层抽样与双线性曲面模型,实现了对面筋含量与强度五项关键指标的同时、快速、无损预测,为全麦粉品质筛查和小麦育种提供了新颖且实用的技术方案。
本文图片转载自 PMC 开放获取全文,仅供学习参考,请以原文为准。